|
|
阿里通义千问团队正式发布 Qwen3.8-Flash。
发布公告有一组让人需要停下来看两眼的数据:
125B 总参数 + 51B N-gram Embedding,每 token 只激活 6B 参数。原生支持 262K 上下文,可通过 YaRN 扩展到 1M。相比 Qwen3.7-Plus,训练开销仅为其 1/9,编码和办公任务上却有更强能力。
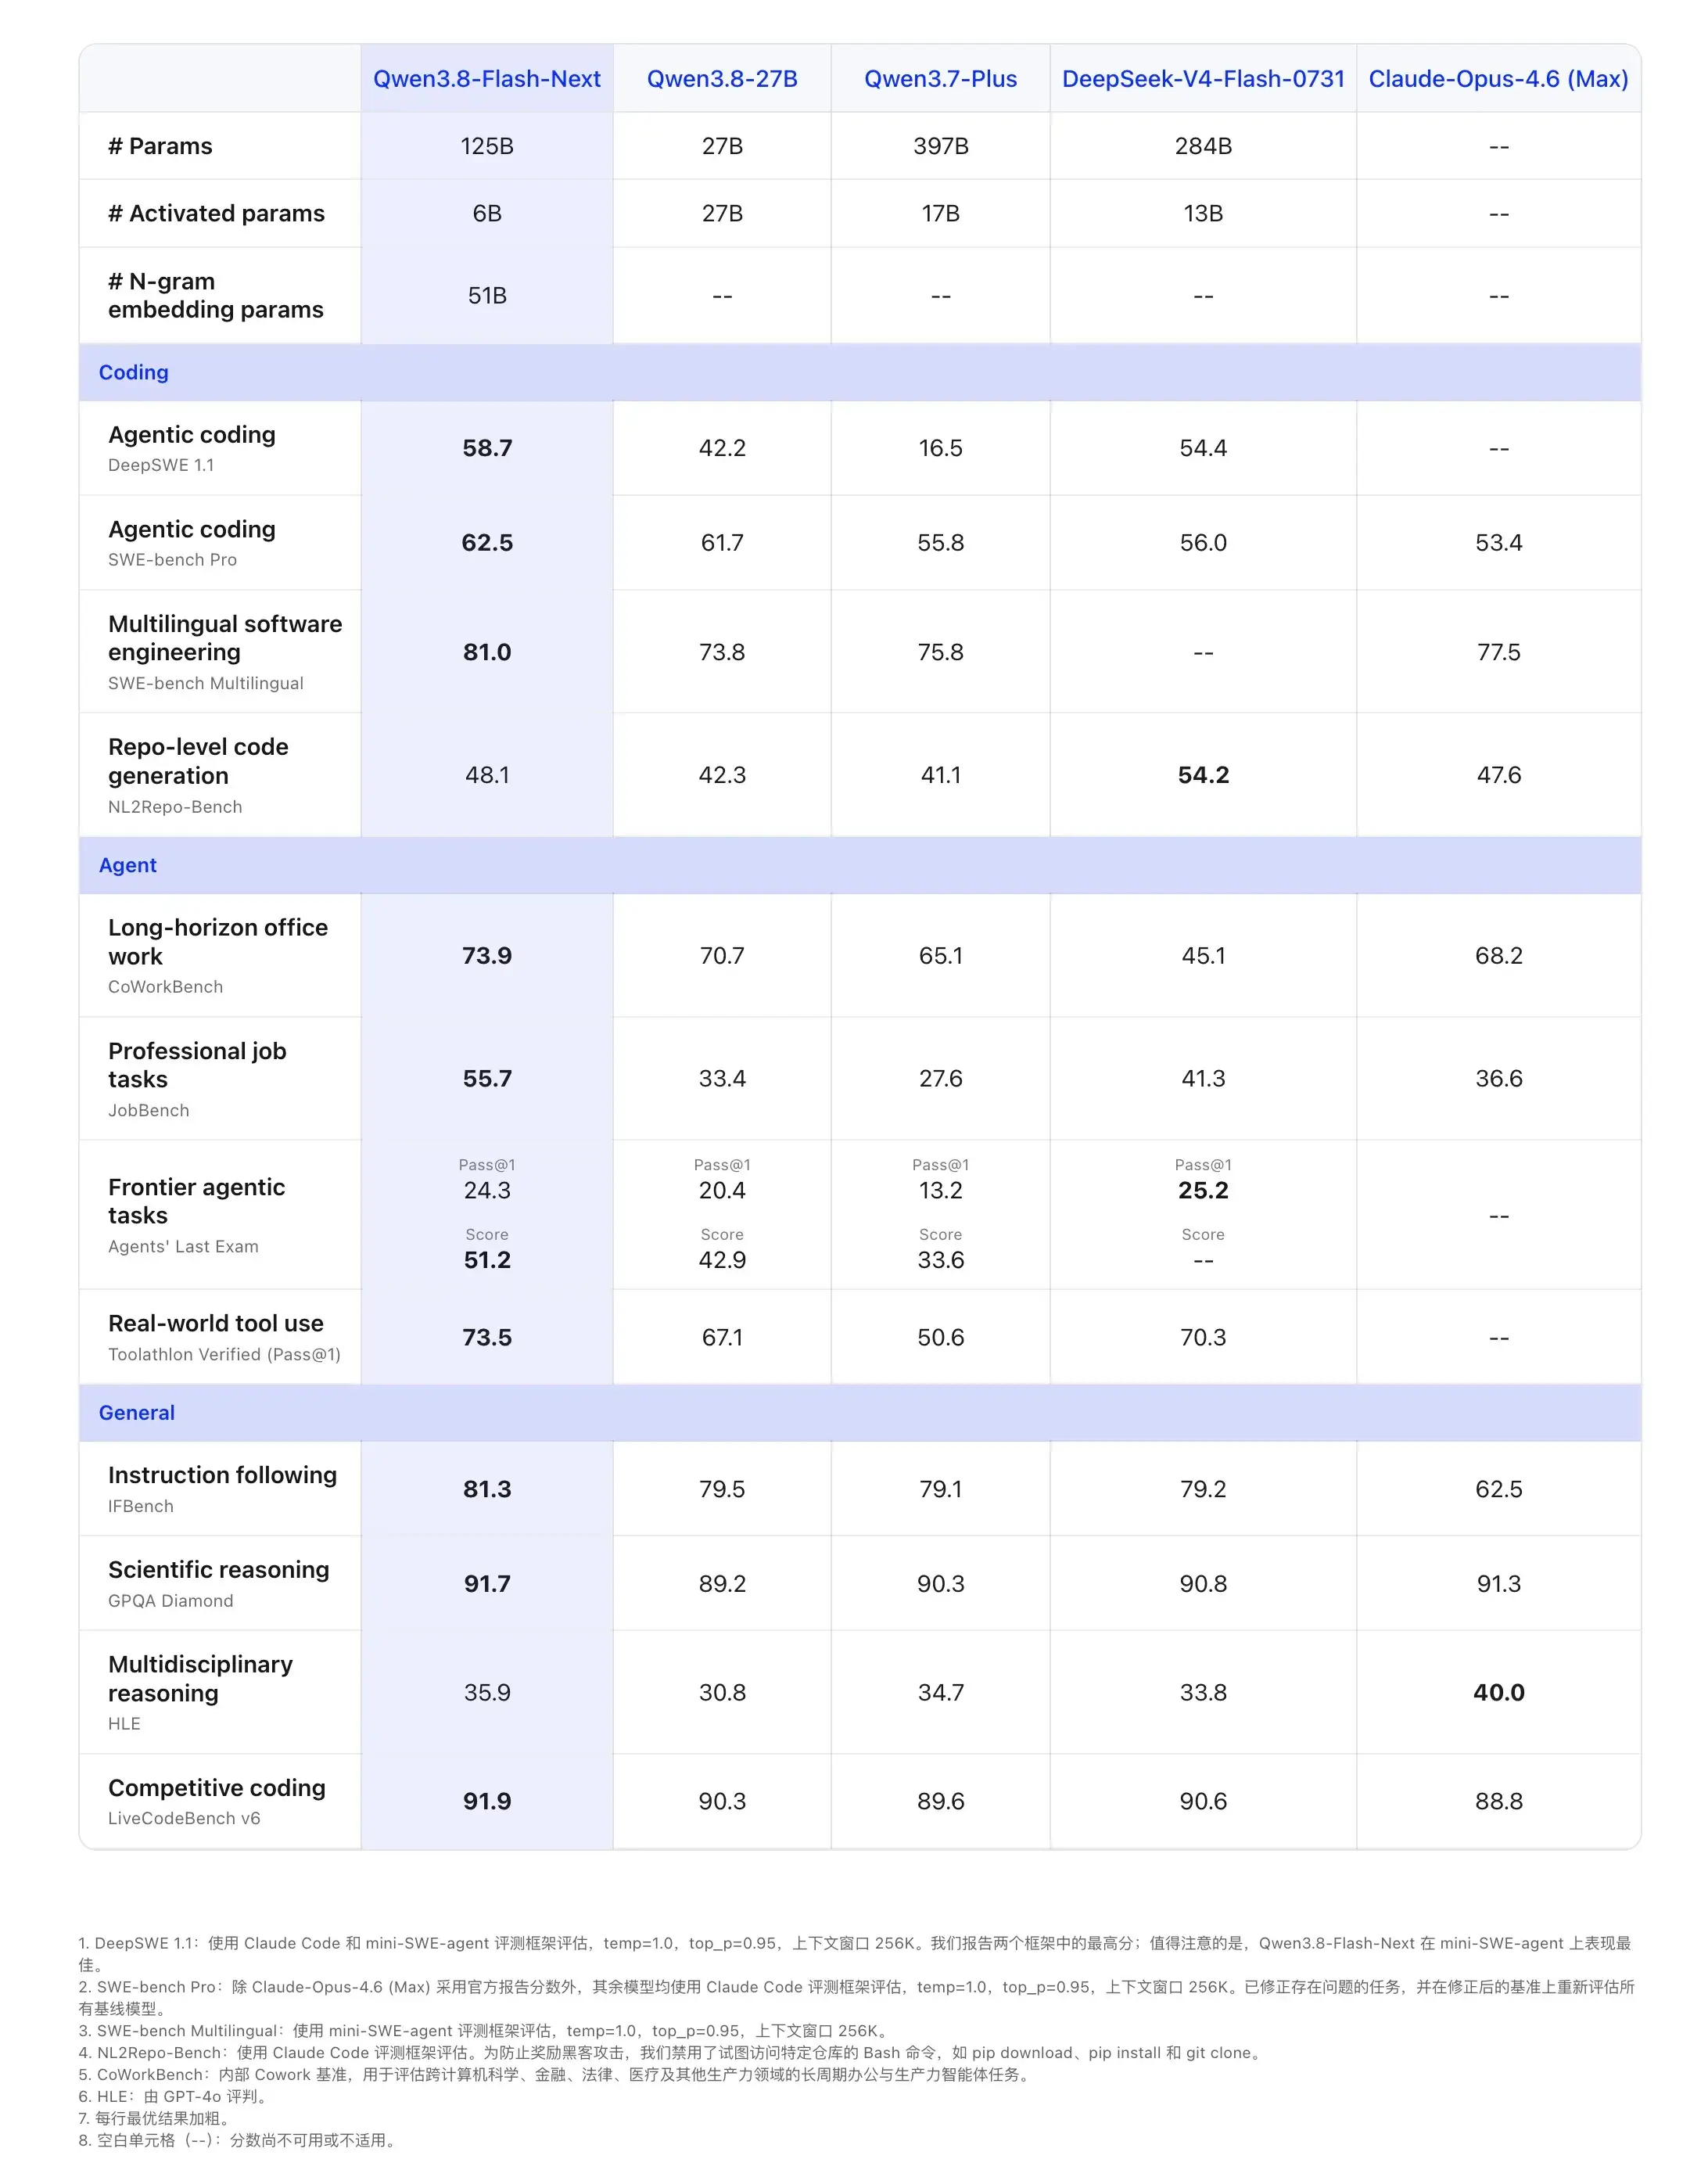
这代模型在架构上有四个值得关注的变化:
Attention 层用了 Gated DeltaNet(GDN)和 Qwen Sparse Attention(QSA)的混合架构。每四层中有三层用 GDN 把历史信息压缩到固定大小的循环状态里,剩下一层保留全局 Attention 做精确检索。QSA 在 block 级别上做稀疏选择,Prefill 阶段最高加速 7.6 倍,Decode 阶段 4.9 倍。1M 上下文、90% Prefix Cache 命中率下,Prefill 吞吐达到 Qwen3.7-Plus 的 8.6 倍。
Residual 连接改成了 Gated Residual——把单条残差流扩展成 4 条并行分支,通过动态门控决定每条分支的读写量。分析发现其中一条分支会自动形成连接第一层和大部分中后层的长距离通道。残差状态可以用 FP8 存,访存开销下来了。
Embedding 层引入了 51B 的 N-gram Embedding。它不是每 token 都参与矩阵运算的常规参数,而是通过局部上下文查表,参数可以卸到 Host Memory,异步 Prefetch 跟模型计算重叠——增加大量参数但不增加每 token 计算量。
优化器换成了 Muon,正交化精度、Muon 与 AdamW 的参数分工做了明确划分:Attention、GDN、MoE Expert 的主力权重用 Muon,Embedding、Router 这些继续用 AdamW。
通义还提前开放了 Qwen3.8-Flash-Next 的开源权重——官方明确说这是 Qwen4 系列模型的雏形。提前释出结构改动,等社区检验完再构建完整模型家族。权重在 HuggingFace 和 ModelScope 都能下到。
Qwen3.8-Flash 现已上线千问 AI 平台,对外提供 API 服务,每百万 Tokens 输入 1 元,输出 3 元。
这个节奏很有意思。阿里通义千问和智谱同一天晚上先后发布了 Qwen3.8-Flash 和 GLM-5.3-Flash。两家都走能力不降级、价格降级的路线,都选了国产芯片做推理部署验证。国内的 Flash 之战,正式开打了。
原文链接 |
|



 发表于 2026-8-27 12:00:20