|
|
过去几年 AI 的叙事几乎全在"训练更大的模型",到 2026 年,风向变了。黄仁勋在 GTC 2026 上把这一年叫做"推理的拐点"。IEEE Spectrum 这篇特稿想说明的一件事是:推理其实和你想象的不一样,它正在逼着整个硬件行业换打法。
先说为什么推理突然变成主角。推理模型会一遍遍自我追问(chain of thought),高推理强度下产出的文本可以是没有推理时的 20 倍;再加上 agentic AI,推理不再只是用户问一句答一句,而是 24 小时不停歇地自主干活。需求爆炸的结果是巨头们开始乱点鸳鸯谱:OpenAI 和 Amazon 用上了 Cerebras 那块餐盘大小的 Wafer-Scale 芯片(尽管 Amazon 自己就有 Trainium),Nvidia 花了 200 亿美元把 Groq 的人才和 IP 买回来,Anthropic 则每月付 SpaceXAI 超过十亿美元租它的闲置算力。
训练和推理的计算性质差得很远。训练靠 backpropagation,GPU 天生擅长。推理则分两段:prefill 读完 prompt、算好所有注意力相关的 key/value,这步并行度高,GPU 是强项;decode 是逐 token 生成,每一个新 token 都要把整个模型权重从头读一遍——而模型可能是几十到几百 GB 的参数,加上能膨胀到几十 GB 的 KV cache。研究人员发现,Nvidia H100 跑开源 LLM 时,有 50% 到 80% 的时间是在等数据,计算单元闲着。
所以内存带宽成了这场革命的真正焦点。d-Matrix 的做法是把计算 die 直接叠在 DRAM 上,让数据搬运距离从毫米级压到微米级;Majestic Labs 走另一条路,用专有的铜连接和 memory-aggregator,把内存接口从 HBM 那 2-3 毫米的"海岸线"延长到约一米,一个机架能挂到 128TB 的便宜 DRAM(对比之下 Nvidia 的 GB300 NVL72 机架约有 20TB HBM3E)。两家都不约而同选了最常见的 DRAM——HBM 要比普通 DRAM 贵两到三倍。
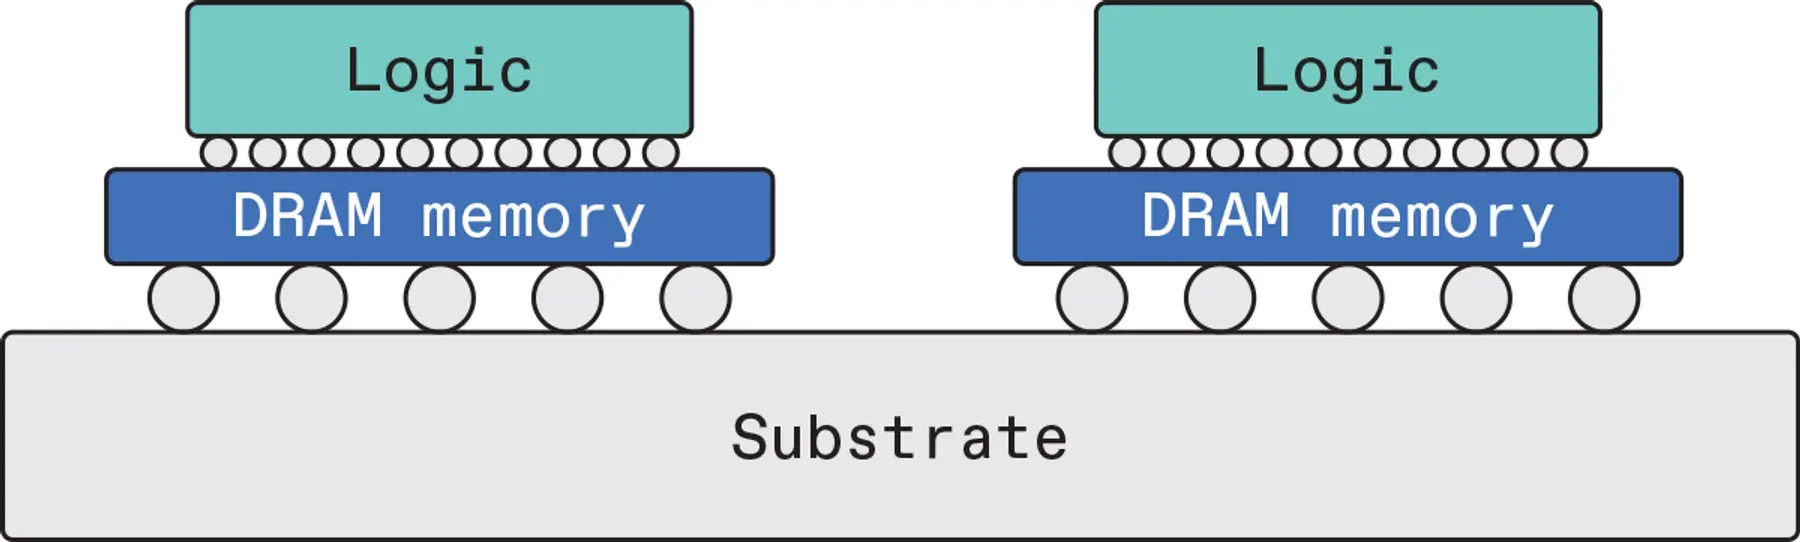
d-Matrix stacked-die 架构
大厂则是"全都要"的组合拳。Nvidia 让 Rubin GPU 干 prefill 的注意力计算,砍掉大部分算力的 Groq 3 LPU 靠 500MB 片内 SRAM 专攻 decode——LPU 的内存带宽是 GPU 的 7 倍,256 颗拼成一个机架大小的 Groq 3 LPX。AWS 的搭配是 Trainium 负责 prefill、Cerebras WSE-3 负责 decode——后者把整片晶圆做成一个芯片,片上刻了 44GB SRAM,能直接装下 40 到 800 亿参数的权重。OpenAI 用它跑 GPT-5.3-Codex-Spark,每秒吐 1000 多个 token,对比标准部署的 50 到 125 个。
软件侧的比特精度优化也在同步进行。Nvidia 造了个 4-bit 格式 NVFP4,AMD、Intel、Qualcomm 则抱团推 MXFP4。Nvidia 说把 DeepSeek-R1 从 FP8 量化到 NVFP4 之后,七个主流基准的分数下降不到 1%,性能却提升了 3 倍。更激进的还有 Tensordyne,用对数数制把芯片里的乘法换成加法,声称 1300 token/秒/用户、功耗不到可比 Nvidia 硬件的十分之一;Etched 干脆把 transformer 结构直接烧进硅片,跑 Llama 70B 能达到每秒 50 万 token,代价是无法适应偏离典型 transformer 的新架构。
哪种会赢?业内更倾向于这不是单选题。Moor Insights 的 Matt Kimball 的说法是,推理需求看不到尽头——"你可以在组织里塞进一百万个 agent,它们一天工作 24 小时,不像我们下午五点到点就下班。" 或许推理硬件会走上 CPU 的老路:不是沿单轴升级,而是多条技术路线同时开花。
来源:
• Inside the Inference Hardware Revolution Of 2026(IEEE Spectrum)
原文链接 |
|



 发表于