|
|
小米 MiMo 大模型团队在官网上挂了一个后训练实时数据面板,正在“公开裸奔”地训练 MiMo 2.6——团队认为 RL 是实现 AI 自我改进的最具可扩展路径之一,将逐步开源训练细节,并提供实时训练仪表盘以展示进展。
打开 mimo.xiaomi.com/rl/,你能看到两个模型——pro 和 flash——当前跑到第几步、每一步接受了多少样本、花了多少钱、燃烧了多少 token,全都实时滚动。此刻面板上写着:pro 已烧掉约 83 万美元,flash 约 36 万美元,两边都以 1,568×16 的批次规模在跑。
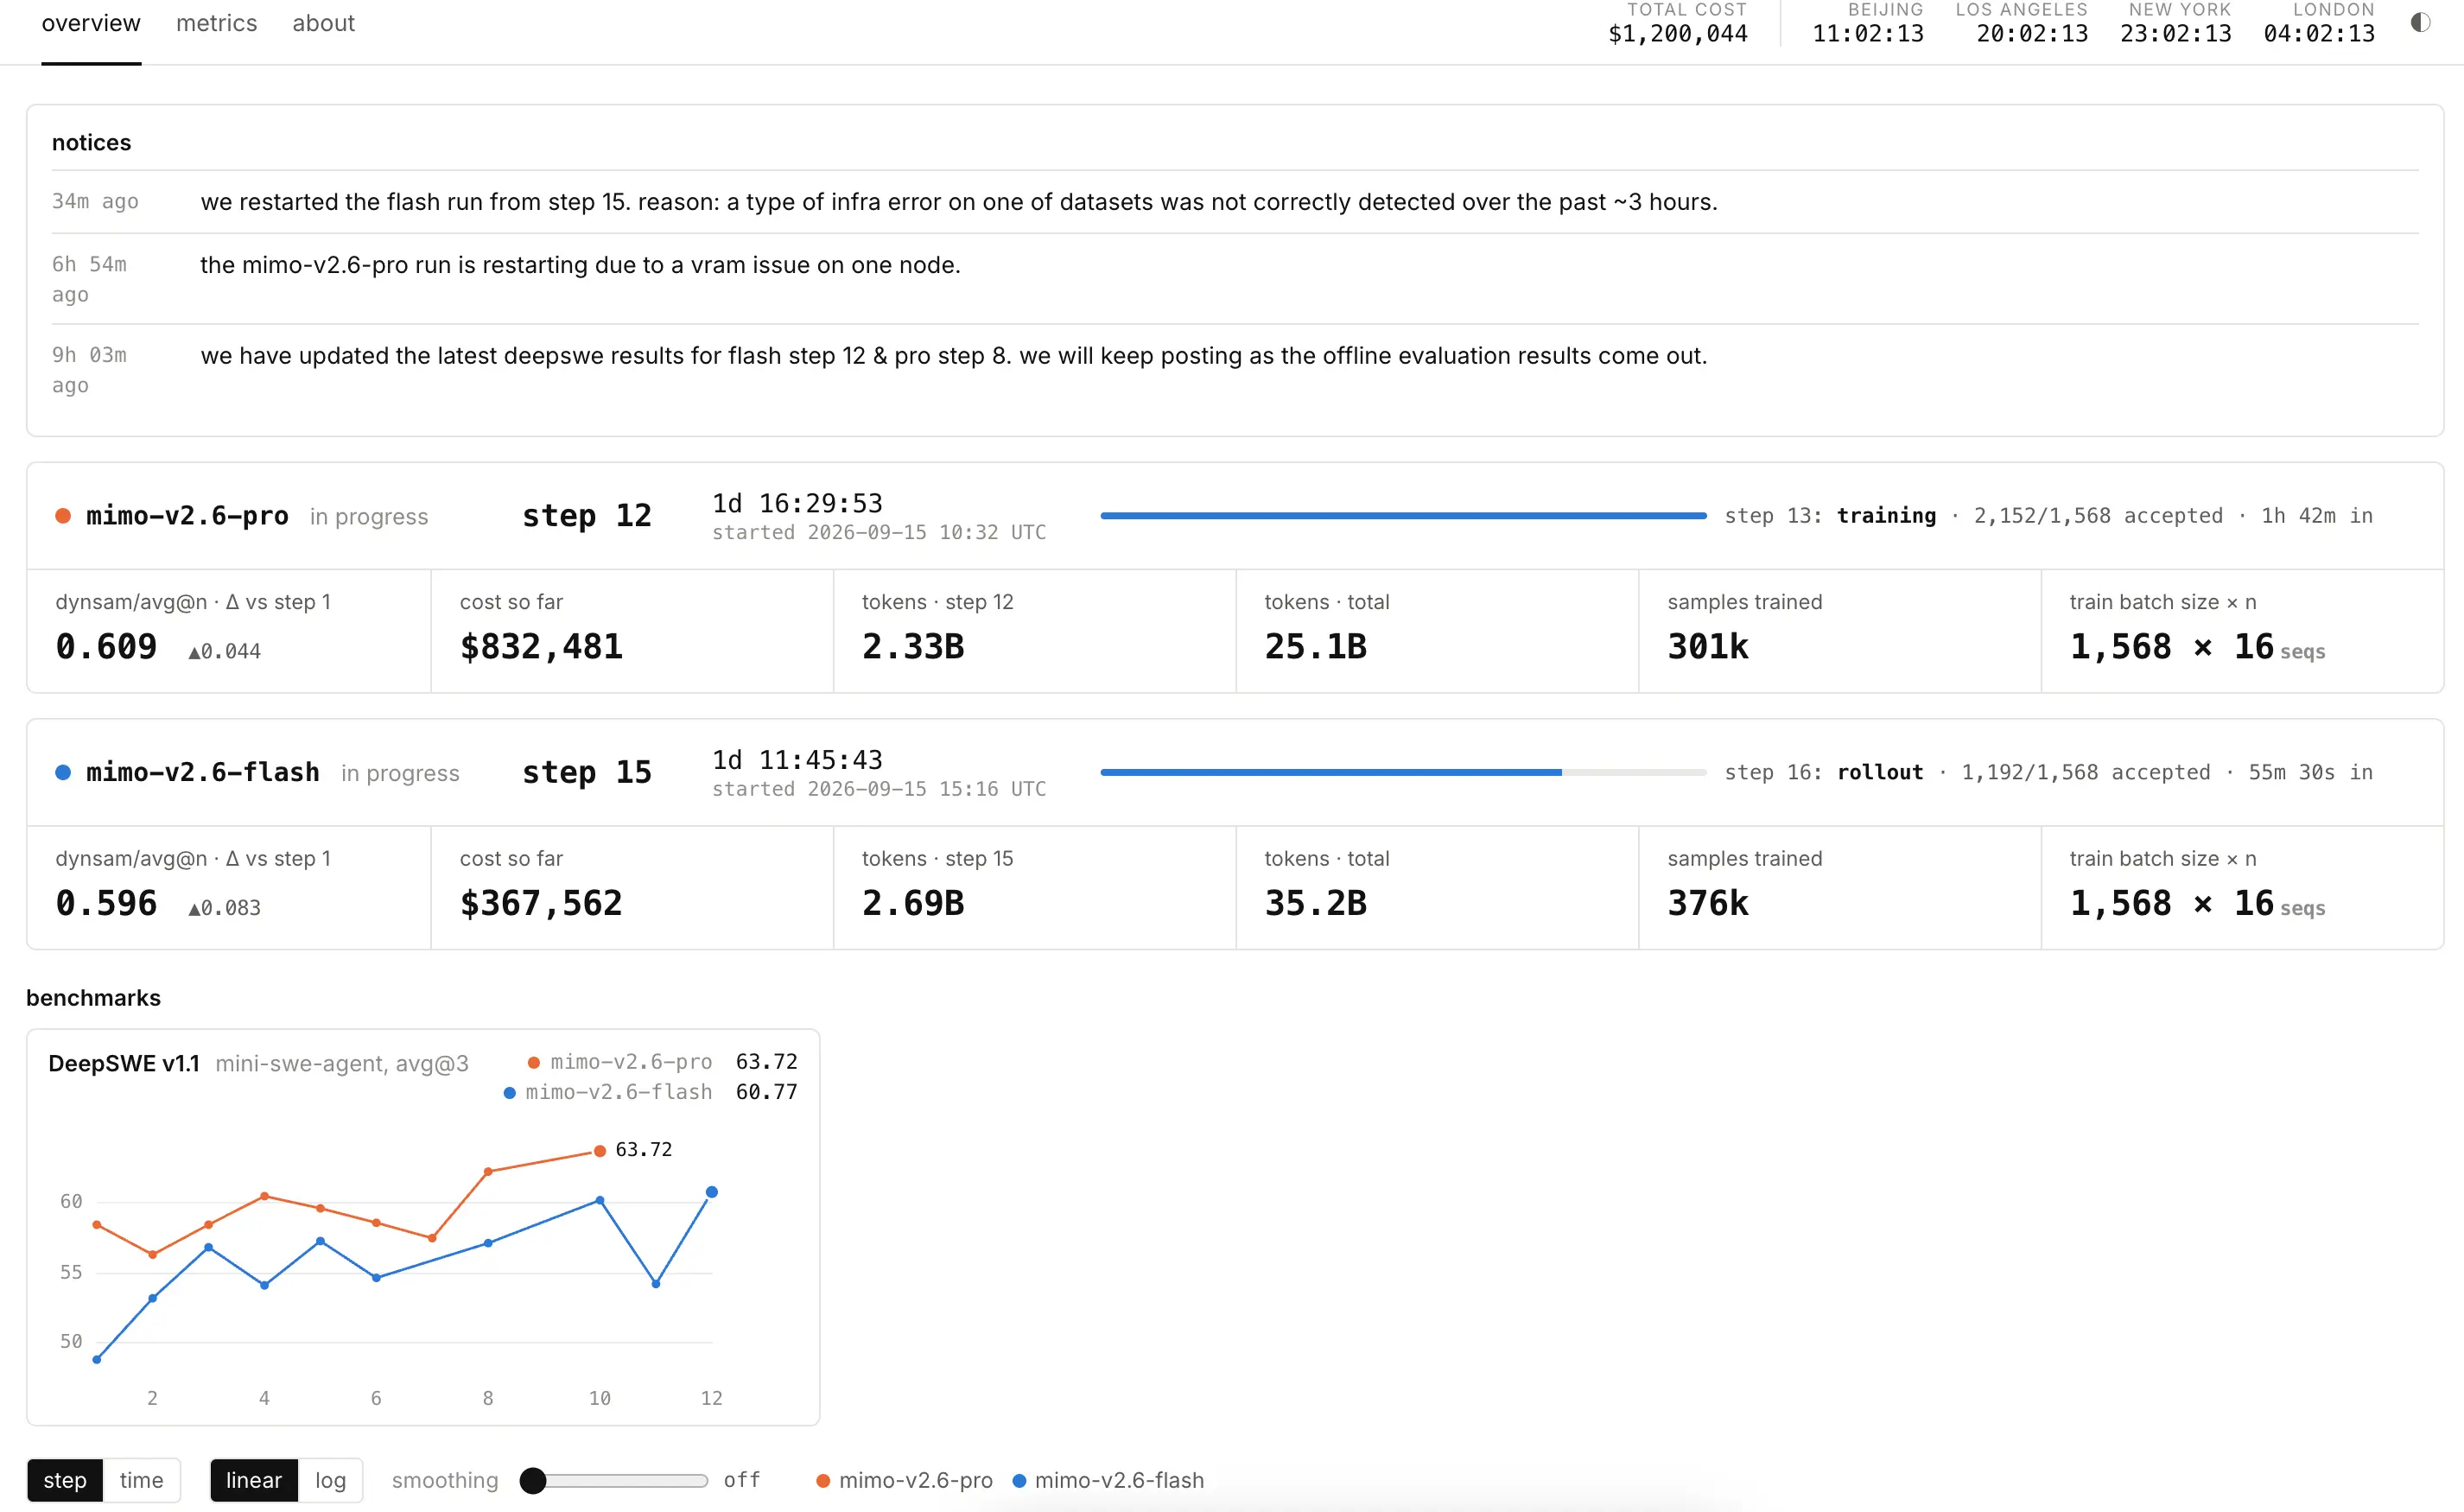
这不是普通的"发布后贴个 benchmark"。小米是把后训练(post-training / RL)过程本身透明化——你在看一台模型在训练中一点点长大,包括它的翻车时刻:面板的 notices 里就记着,flash 昨天因为有个数据集上的基础设施错误没被及时检测到,从第 15 步重新启动;pro 也因为某个节点 VRAM 出问题重启过一次。失败、回滚、重来,全摆在那。
性能数据也在实时更新。面板显示的是 DeepSWE v1.1(mini-swe-agent,avg@3)的编码基准:当前 pro 63.72、flash 60.77,还画了随 step 变化的曲线。打法和 DeepSeek 如出一辙——用编码能力当招牌,靠极低的价格抢开发者心智。
小米 MiMo 大模型负责人罗福莉在 X 上解释了一句:"近半年沉默,我们只用来研究一个问题——RL 到底能扩展到多远。" MiMo-V2.6 现在正跑到 RL 的中间,这次直播就是给这场实验配的一扇观察窗。
这次他们明确说扩张了三个东西。一是算力:每步约 20 亿 token,1568 个 prompt × 16 路 rollout,全异步。二是环境和 harness:多任务 agentic RL,在一次训练里混合多个 harness 同时跑。三是 grader 算力:agentic 组内 credit 分配,用测试用例和 rubric 两种奖励。三块摊开,对应的是 RL 从"单任务刷分"往"多任务 agent 真干活"推进时,最卡脖子的那几个环节。
直播面板上的实时数据就是这三个扩张的代价和进度的具象化。此刻 pro 已烧掉约 83 万美元,flash 约 36 万;编码基准 DeepSWE(mini-swe-agent,avg@3)pro 63.72、flash 60.77。连失败都不藏着——flash 昨天因数据集基础设施错误没被及时检测到,从第 15 步重启;pro 也因某节点 VRAM 问题重启过一次。
这个"训练过程直播"的动作本身,比具体分数更值得注意。以前模型厂商给世界看的,是训完那一下的最终数字;现在小米把中间过程也摊开——真金白银、实时失败、逐个 step 的曲线。是把 open 玩到了另一种维度:不只是开源权重,连"怎么把它训出来"都变成了公开的可观看节目。
来源:
• Xiaomi MiMo 2.6 live post-training dashboard
• Fuli Luo 官宣推文
原文链接 |
|



 发表于 2026-9-17 11:30:09