|
|
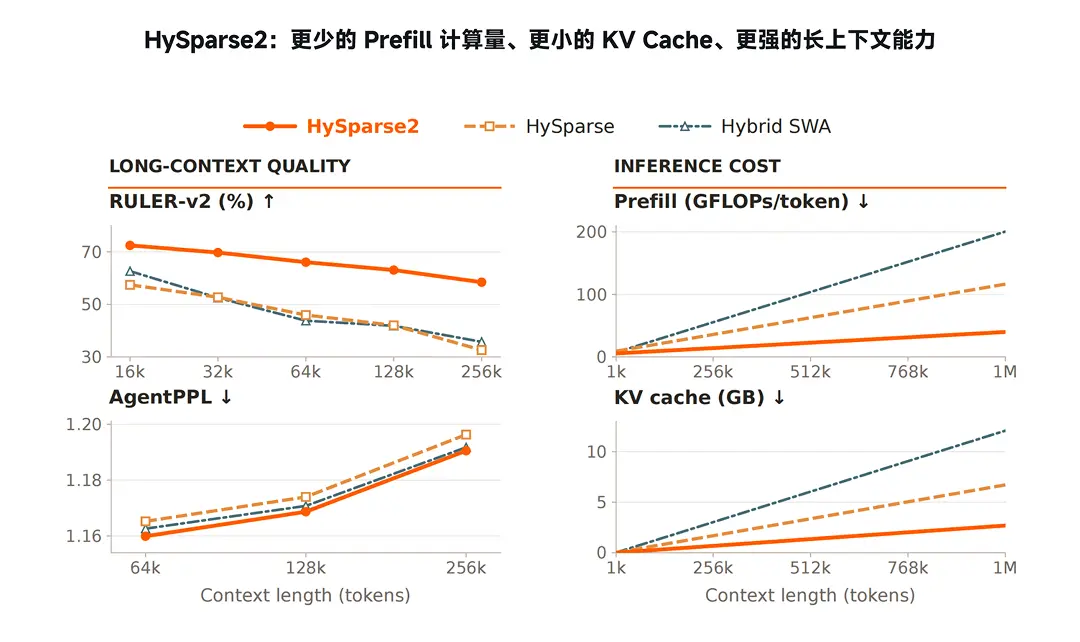
小米 MiMo 团队负责人罗福莉(Fuli Luo)在 X 上预告了 MiMo-V3 的新推理架构 HySparse2,随后小米官方公众号也放出了完整介绍。面向长程多轮 Agent,这套方案的三个目标很直接:更少的 Prefill 计算、更小的 KV Cache、更精准的长上下文检索。

和 MiMo-V2.6 的 Hybrid SWA 相比,相对收益的系数是现成的:在百万 token 成本分析里,Prefill 计算量降至 1/5(约 5 倍),KV Cache 从 12GB 压到 2.7GB——按 1M token 上下文算缩小了约 4.5 倍。MRCR-v2、RULER-v2 长文检索基准也有提升,AgentPPL、LongPPL 更低。相对第一代 HySparse,Prefill 计算量降至 1/3,KV Cache 从 6.7GB 降到 2.7GB,后训练后 MRCR-v2 和 RULER-v2 各报告长度平均分分别提高 11.30 和 19.81 个百分点。
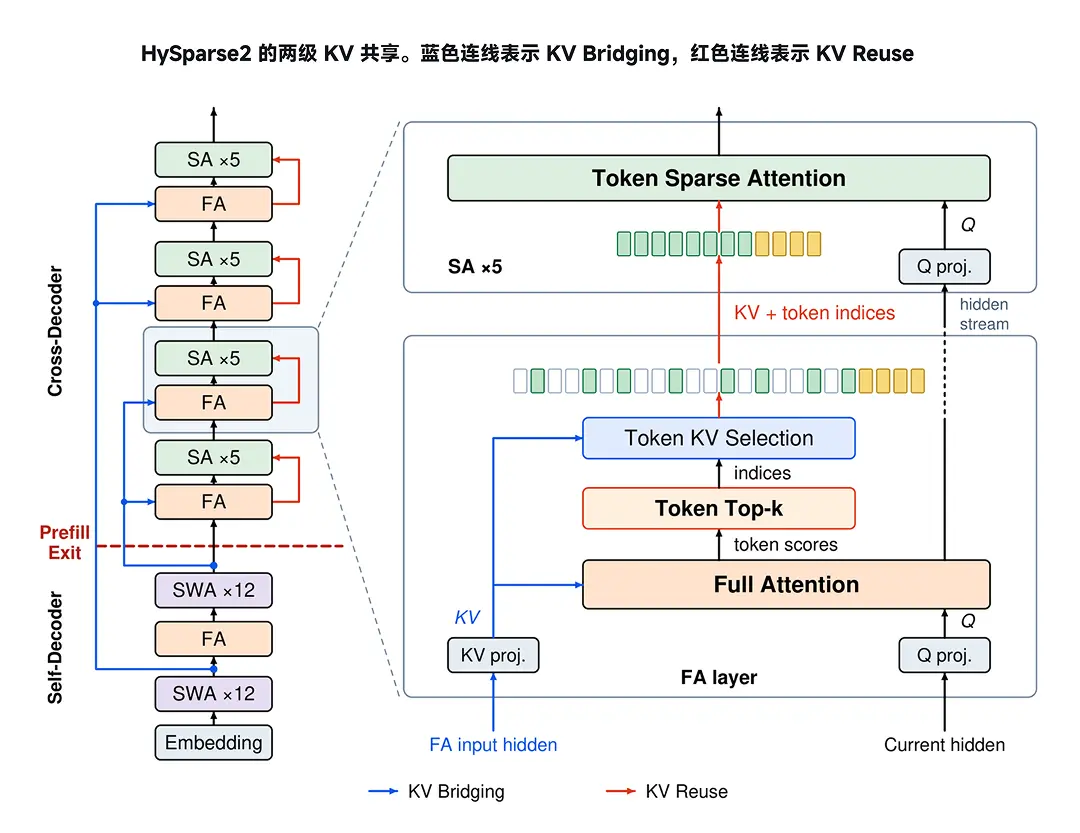
省 KV 靠的是两级 KV 共享。模型照 YOCO 的思路拆成前后两半:第一级 KV Bridging 让后半部分(Cross-Decoder)的 Full Attention 层直接从前半部分(Self-Decoder)对应层的输入隐藏状态生成自己的 KV Cache——这些缓存不必等输入逐层流过 Cross-Decoder,在前半段就把 KV 建好了;第二级 KV Reuse 让同一 Hybrid Block 里的稀疏层直接复用 Full Attention 层算好的 KV Cache 和选择索引,不用额外训独立选择器。
配合 token 级稀疏选择(第一代是块级,这会为选中一个重要 token 往往连整块算进去;现在按 token 分配预算),加一个强制保留最近 128 token 的局部窗口,窗口外再选 1,024 个全局 token,两部分合进同一次稀疏注意力计算。
这套拆分顺手把 Prefill 的路径切短了:49 层模型里,Prefill 只需要执行前 25 层 Self-Decoder 和桥接 KV 投影,其中只有一层 Full Attention。Prefill-Decode 分离部署时,Prefill 节点只需部署这部分网络,模型权重存储接近减半。
换句话说,「缓存更小、Prefill 更短」和「长文检索更好」没有互相拆台。连同此前通过低比特量化、投机解码等做快速 Decode 的 MiMo-UltraSpeed,小米是想让模型在同一规模下 Prefill、Decode 两头都快。
来源:
• Fuli Luo on X: MiMo-V3 gets HySparse2
• HySparse2:Xiaomi MiMo-V3 新架构预览
• arXiv 2609.26368 — HySparse2: Hybrid Sparse Attention with Two-Level KV Sharing
原文链接 |
|



 发表于 2026-9-24 17:00:19