|
|
Anthropic 今天发了一篇博客,讲他们怎么对付『蒸馏攻击』——一种隐蔽的、工业规模的、用大量非法账号从另一个模型批量抽取能力的做法:从更强、更大的模型(这里就是 Claude)生成数百万条回复,再拿这些回复去教一个更小的模型模仿前者的行为,从而用开发时间和成本的一小部分就逼近前沿能力。Anthropic 说过去几个月他们大幅削弱了这类攻击的有效性,早期证据显示蒸馏者捕获的数据量下降了大约 90% 到 99%。
为什么他们这么在意蒸馏?官方给出了两个理由。第一,蒸馏让一些公司能建出逼近能力前沿的模型,但这些模型发布时却没有配得上其能力的防护措施——官方举例称,某个模型厂商在开发 GLM-5.3 的过程中蒸馏了美国头部模型的网络能力,最初想蒸馏 Claude 的某个版本,在发现 Claude 的网络防护会削弱其攻击后,又换成了一个更老版本的 Claude 和另一家实验室的模型。第二,蒸馏出的模型构成国安风险——蒸馏方把从美国模型获得的能力,整合进外国的军事、情报和监控系统。
防御的核心集中在一点:让 Claude 的推理过程更难被蒸馏者拿到。因为对蒸馏最有价值的数据不是输出本身,而是 Claude 在回答前写下的思考过程(reasoning/thinking)——它能让小模型学会 Claude 是怎么一步步得出最终答案的。
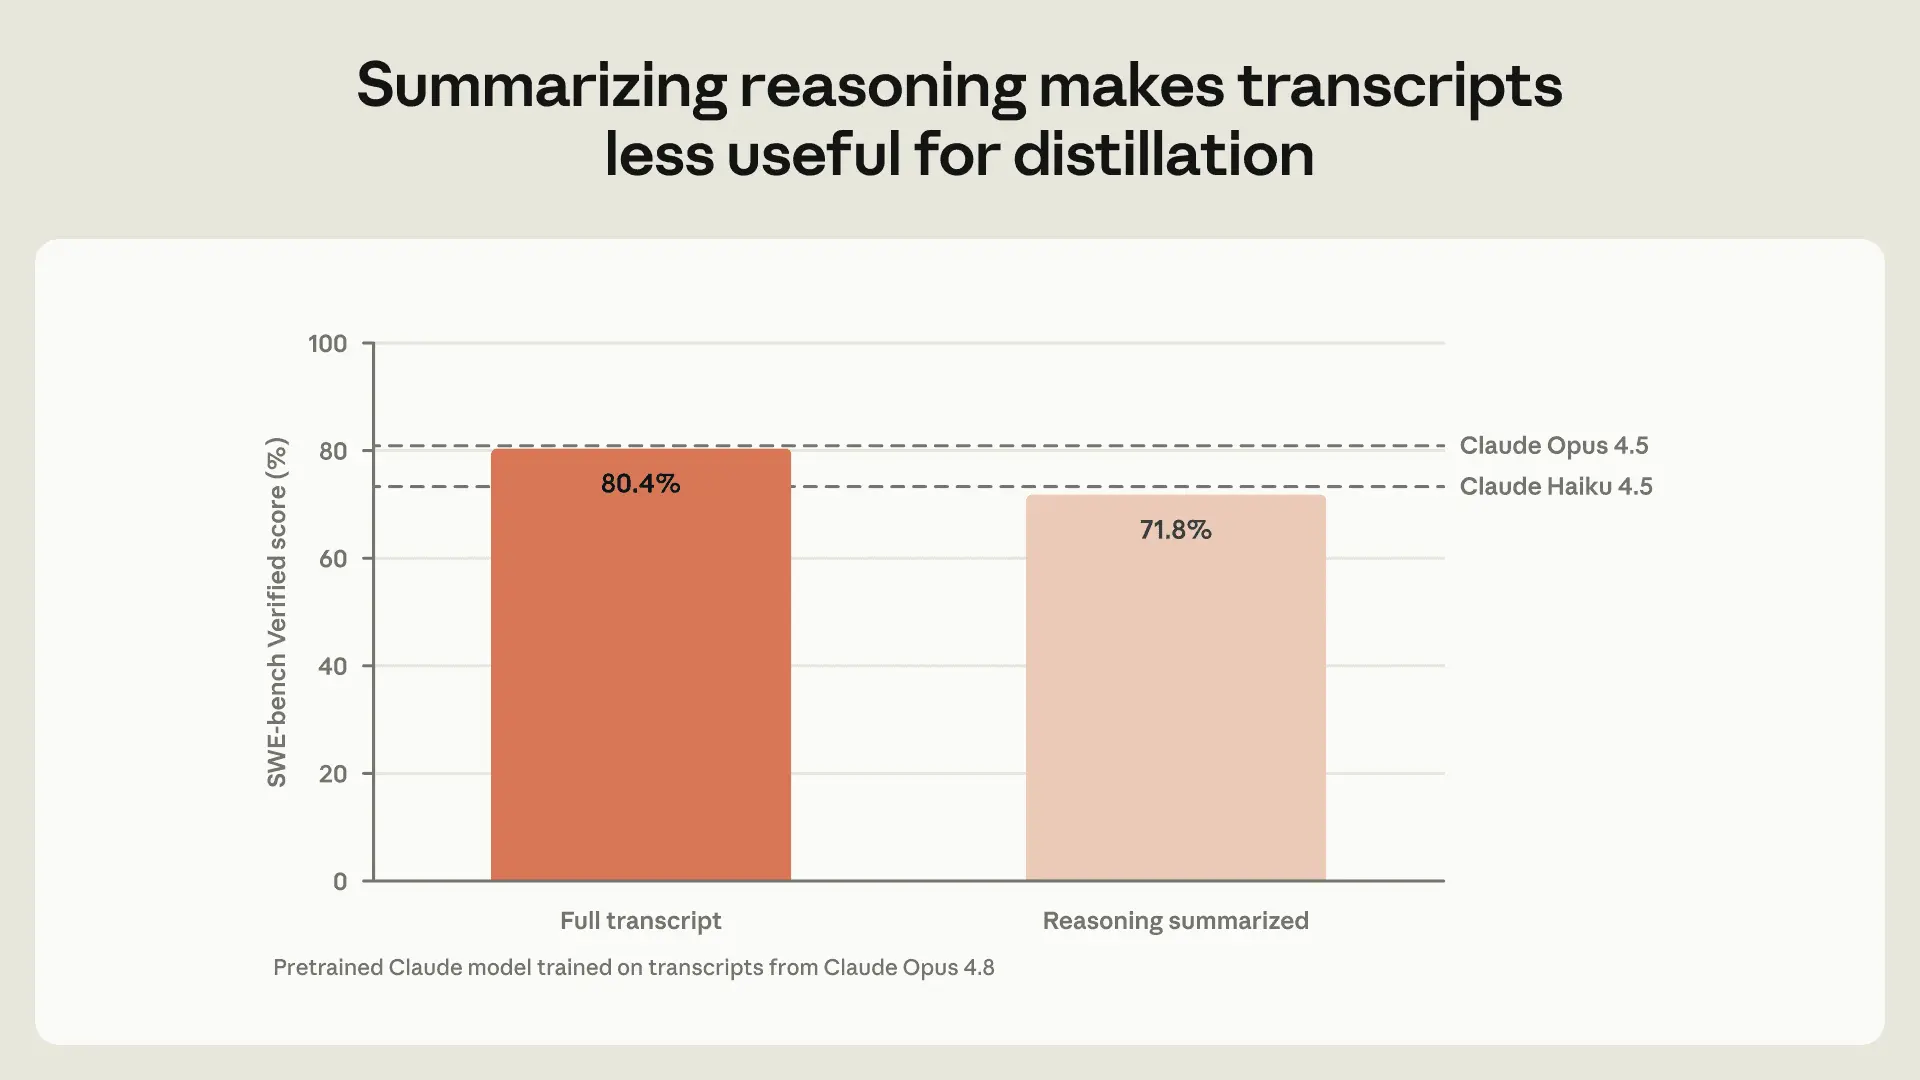
Anthropic 最初的一个简单措施,是让 Claude 先把推理『总结』一遍再展示给用户。他们做了个对照实验:拿 Claude Opus 4.8 的推理记录去训练一个预训练模型,用完整推理记录训练的在 SWE-bench Verified 编码基准上拿到 80.4%,而只给总结版推理的只到 71.8%——总结让转录对蒸馏者的价值大大降低。
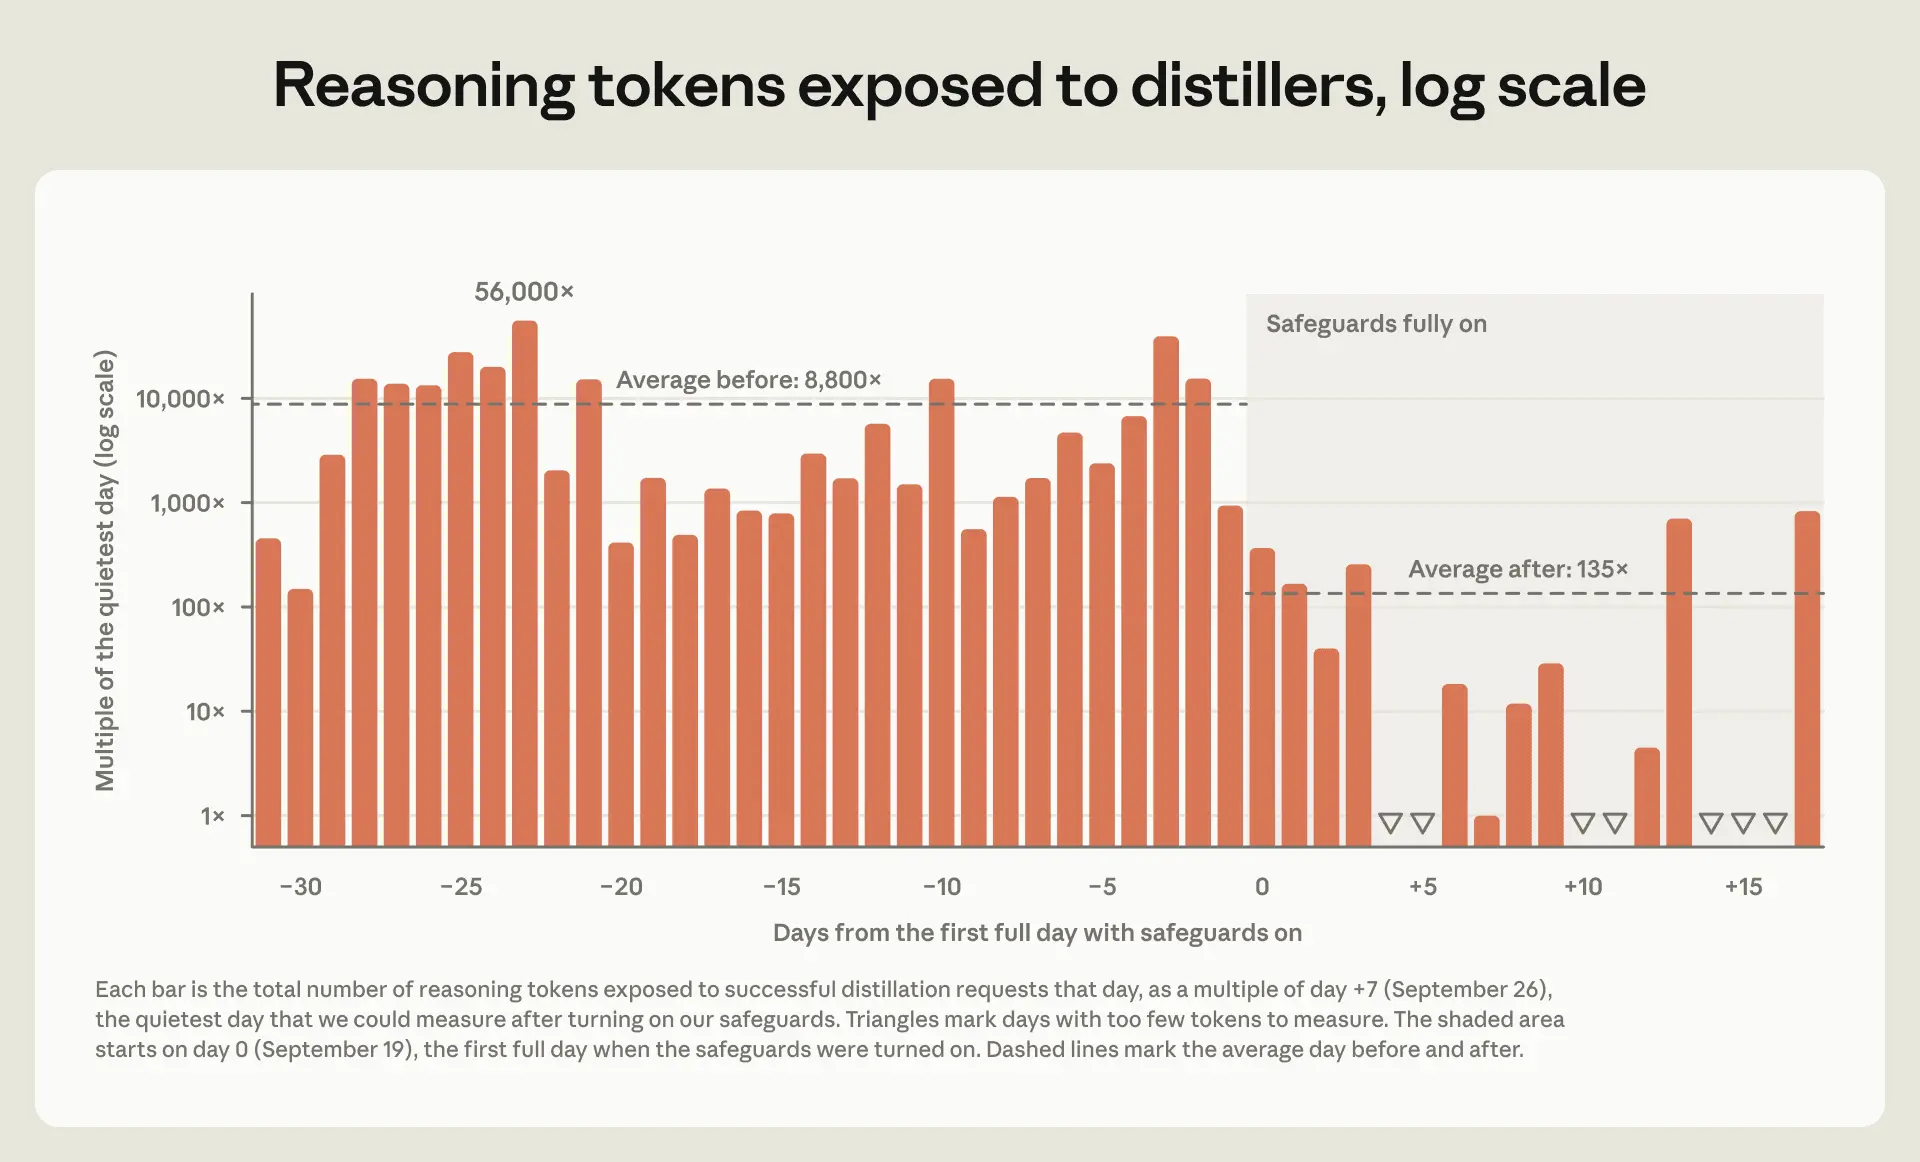
但蒸馏者不是被一个补丁就挡住的,被动蒸馏被压制后,他们转向了主动抽取。Anthropic 承认这些防御有代价:他们拒绝了蒸馏者带来的可观收入和数以万亿计的 token 流量,研究和产品团队投入了大量时间,一些改动还要求正当用户更新他们的集成方式。Anthropic 最后公开呼吁——『蒸馏是每个模型开发者都面对、都必须应对的问题』,希望这篇能让开发者和平台更好地理解如何阻止攻击、这些措施有哪些权衡,以及为什么这些成本值得承担。
来源:
• Strengthening our defenses against distillation attacks - Anthropic
原文链接 |
|



 发表于 2026-10-13 15:30:14