|
|
•
企业接入大模型,最难的不是技术,是秩序。本文分享一个开源思路:在内网部署一层轻量 API 网关(llm-proxy-tk),让大模型像公司内部的水电一样——统一接入、按人发卡、用量可视、随时断供。
•
过去一年,我接触了不少中小企业和团队,发现大家用大模型的方式惊人地一致:
•
现状一: 密钥在群里裸奔。**
某个员工注册了 DeepSeek 账号,把 API Key 发到工作群里,全组共用一个 Key。谁用超了不知道,谁泄露了说不清,月底账单一出来,互相猜是谁干的。
•
现状二: 数据在公网上"裸奔"。**
•
更隐蔽的风险是: 员工为了让工作更高效,直接把产品代码、客户合同、财务数据贴进各种公开网页版的对话框。数据出了域,你连它去了哪儿都不知道。等出了事,追溯无从谈起。
•
现状三: 接了一个模型,被一个模型绑架。**
团队写代码时用 Claude,做中文内容用 DeepSeek,跑本地部署用 Ollama——每个客户端一个地址、一个 Key、一套配置。想从 A 模型切到 B 模型,所有接入方都要改一遍;想统一统计各模型的用量,发现根本没有数据。
•
这三个问题的共同根源是: 大模型在企业内部缺一个"总闸门"。
就像公司不会让每个员工自己拉一根电线、打一口井,大模型这种生产资源,也需要一个统一入口。
二、思路:不卖算力,只做"自用网关"
•
先划清边界: 这篇文章说的不是做对外业务、不是转售 API、更不是搭平台卖 token——那是另一条充满合规风险和红海竞争的路。
我们讨论的是一个更朴素、也更快落地的场景:
企业自建一层大模型 API 网关,只对自己人服务。
它要解决的问题清单很明确:
2. 按人发卡:每个员工/部门/应用一个独立 sk- 密钥,密钥绑定到各自该用的模型
3. 真实密钥不下发:上游厂商的 API Key 只存在网关里,员工手里永远是网关发的"内卡"
4. 用量可审计:谁调了多少次、烧了多少 token,按天/周/月一目了然
5. 随时断供:员工离职、密钥泄露,一键吊销或重置,秒级生效
6. 数据可选不出域:敏感业务接本地 Ollama / vLLM,网关照常管理
这就是 llm-proxy-tk 这个项目的定位——一个基于 FastAPI 的轻量大模型网关,SQLite 存数据、Docker 一键起,单文件部署,专门给"自用"场景设计。
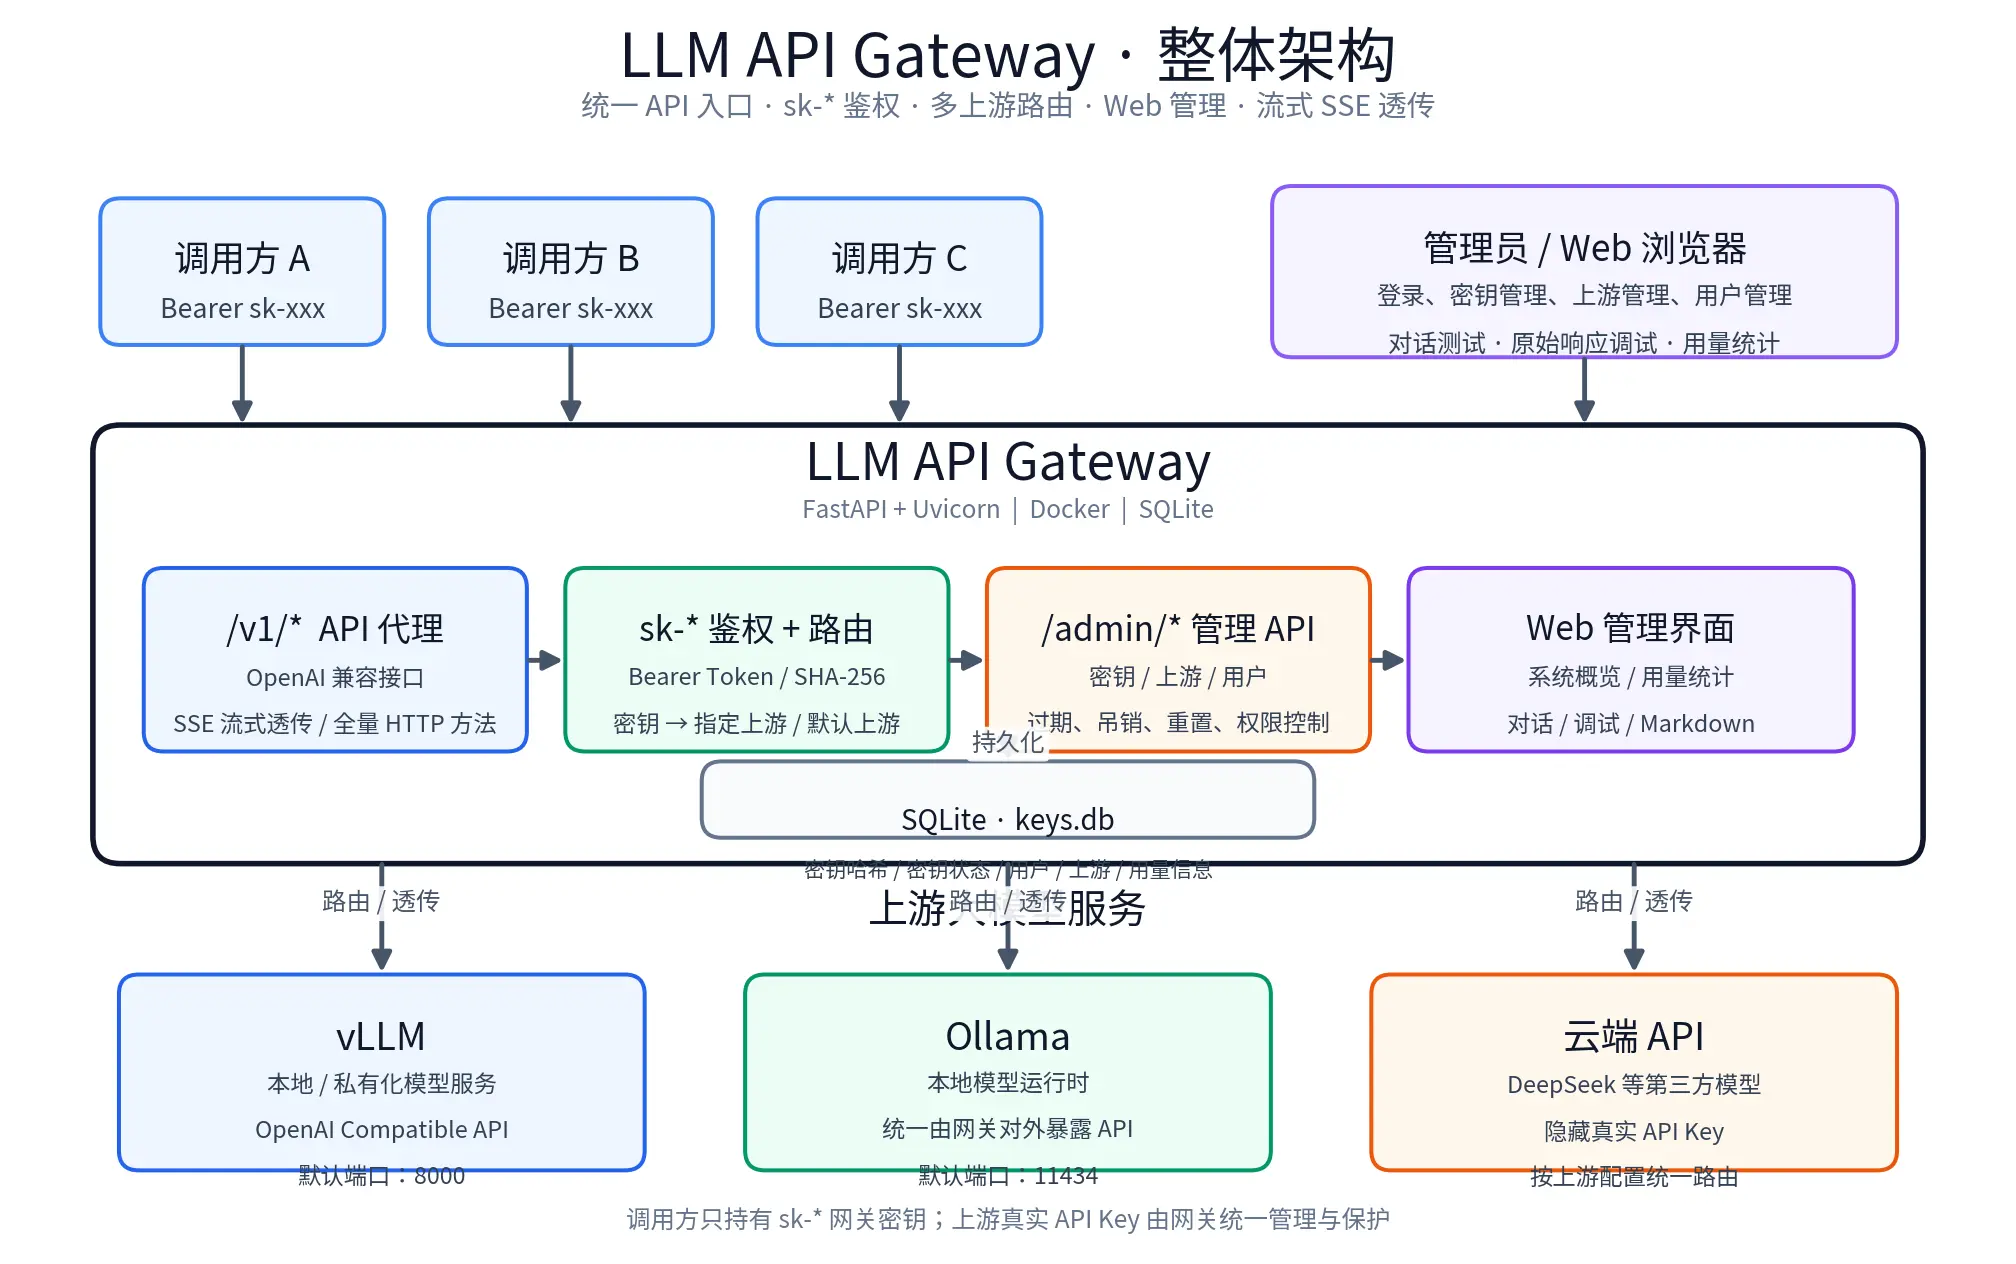
三、架构:一层很薄的"智能总闸"
•
整个系统一句话就能说清:
- 员工A的IDE ──┐ ┌──▶ 本地 Ollama (qwen3)
- 员工B的脚本 ──┤ ┌──────────────┐ ├──▶ 本地 vLLM (deepseek-coder)
- 部门C的应用 ──┼──▶│ llm-proxy-tk │─────┼──▶ DeepSeek 云端 API
- 网页版对话 ──┤ │ 统一 /v1/* │ └──▶ Claude / 其它 OpenAI 兼容上游
- ──┘ └──────────────┘
- 每人一把 sk- 密钥,按密钥路由、鉴权、计量
调用方拿到的是一个标准 OpenAI 格式的接口:
- curl http://gateway.你的内网:9000/v1/chat/completions \
- -H "Authorization: Bearer sk-张三的密钥" \
- -H "Content-Type: application/json" \
- -d '{
- "model": "deepseek-chat",
- "messages": [{"role": "user", "content": "帮我总结这份合同"}],
- "stream": true
- }'
对员工来说,体验和直接调官方 API 没有任何区别——改个 base_url 就接上了。所有的"秩序",都发生在网关这一层。
四、六个落地场景,讲透它能干什么
场景 1:密钥管理——从"群里裸奔"到"按人发卡"
•
在管理后台给每个员工、每个应用发放独立密钥,可以设置过期时间(比如外包人员给三个月):
•
密钥未绑定上游时走默认上游,绑定了就固定路由到指定模型
•
列表里只显示 sk-ab12** 脱敏前缀,明文只在创建时回显一次
•
密钥泄露/丢失?点一下"重置":立即换发新钥,旧值即刻失效,名字、绑定关系、历史统计原封不动——相当于换了锁芯没换门
场景 2:多模型并存——告别供应商绑架
•
"上游管理"里可以同时配置任意多个模型服务: 本地 Ollama、本地 vLLM、DeepSeek 云端、智谱、任何 OpenAI 兼容端点。
每个上游标注协议类型(OpenAI / Anthropic)和可用模型清单。网关会自动做双方言翻译:OpenAI 客户端的请求可以打到 Anthropic 协议的上游,流式 SSE 照样翻。这意味着团队里的老代码一行不改,就能从 A 模型迁到 B 模型——迁移的成本,从"改 N 个客户端"变成"改 1 个后台配置"。
场景 3:用量审计——每个 token 都有账
•
这是我最推荐企业关注的能力。网关自动解析每次调用的 usage 并落库,统计页提供:
•
日 / 周 / 月三种粒度的调用量与 token 趋势
•
密钥 × 周期矩阵:一眼看出哪个部门这个月烧了多少钱
•
输入 / 输出 token 分开统计,缓存命中 token 单独一列——对用了提示词缓存的团队,这就是省钱报表
•
每个密钥的请求次数、最后使用时间
月底老板问"AI 这块花了多少、谁在用、用得值不值",导出数据就能回答。
场景 4:数据不出域——敏感业务的底线
•
财务、法务、核心代码这类数据,接公开 API 终究心里不踏实。把 Ollama 或 vLLM 部署在内网 GPU 机器上,作为网关的一个上游:
•
员工用同一把密钥、同一个地址,无感切换到本地模型
•
数据全程不出公司网络
•
用量统计照常工作,本地模型烧的是电费,也照样记 token——方便评估"这个场景值不值得上一张卡"
场景 5:内置对话页——顺手解决"网页版裸奔"
•
管理后台自带一个聊天界面: 流式输出、Markdown 渲染、代码高亮、多轮上下文。员工日常问答不需要再去外面的网页版——与其堵,不如给一个更顺手的。管理员还能直接在对话页选择任意密钥、任意上游模型做调试,排查问题不用 curl。
场景 6:权限分级——不是人人都是管理员
•
后台账号分管理员 / 查看者两种角色: 查看者能看统计、看密钥列表,但发卡、重置、改上游这些写操作只有管理员能做。审计和操作分离,权责清晰。
五、部署有多简单?
一页纸说完。
•
Docker 方式: **
- docker build -t llm-api-gateway .
- docker run -d \
- --name llm-api-gateway \
- -p 9000:9000 \
- -e MASTER_KEY=改成你自己的管理密码 \
- -v "$PWD/data:/app/data" \
- --restart unless-stopped \
- llm-api-gateway
•
裸机方式: **
- cd proxy
- pip install -r requirements.txt
- python main.py
没有数据库要装(SQLite 文件即数据),没有消息队列,没有 K8s。一台普通的内网服务器,五分钟从零到可用。内网机器没有外网?项目还提供了离线部署包,pip 依赖全部本地化,前端渲染库也全部 vendor 本地打包,断网环境照常跑。
六、什么样的问题它不解决
•
实事求是,边界也要讲清楚:
•
它不做计费充值——没有余额、扣费、订单。内部成本核算用统计报表就够了,真要对外卖 token 是另一回事(也不建议做,那是红海)
•
它不做内容安全审核——违规内容过滤需要接专门的内容安全服务
•
它不是高可用集群——单实例 + SQLite,定位是中小团队的内网总闸,不是日均亿级调用的平台
•
一句话: 它是给"想管好自己人怎么用 AI"的团队用的,不是给"想做 AI 生意"的人用的。
七、写在最后
大模型落地企业,唱主角的永远是场景和流程,但基础设施的秩序感决定了它能走多远。
一台内网网关改变不了业务,但它把三件重要的事变成了默认选项:密钥可控、用量可见、数据可守。当"哪个部门用了多少、数据有没有出域"从灵魂拷问变成后台一屏数据,企业才敢真正放手让员工把 AI 用起来。
把大模型变成公司的"自来水"——拧开就有,每户有表,坏了能关。这就够了。
•
项目地址: github.com/boonya-hrgk/llm-proxy-tk(开源,仅供学习与内部使用)
如果这篇文章对你有帮助,欢迎点赞、在看、转发给正在为"密钥裸奔"头疼的朋友。
原文链接 |
|



 发表于 2026-9-4 08:15:29