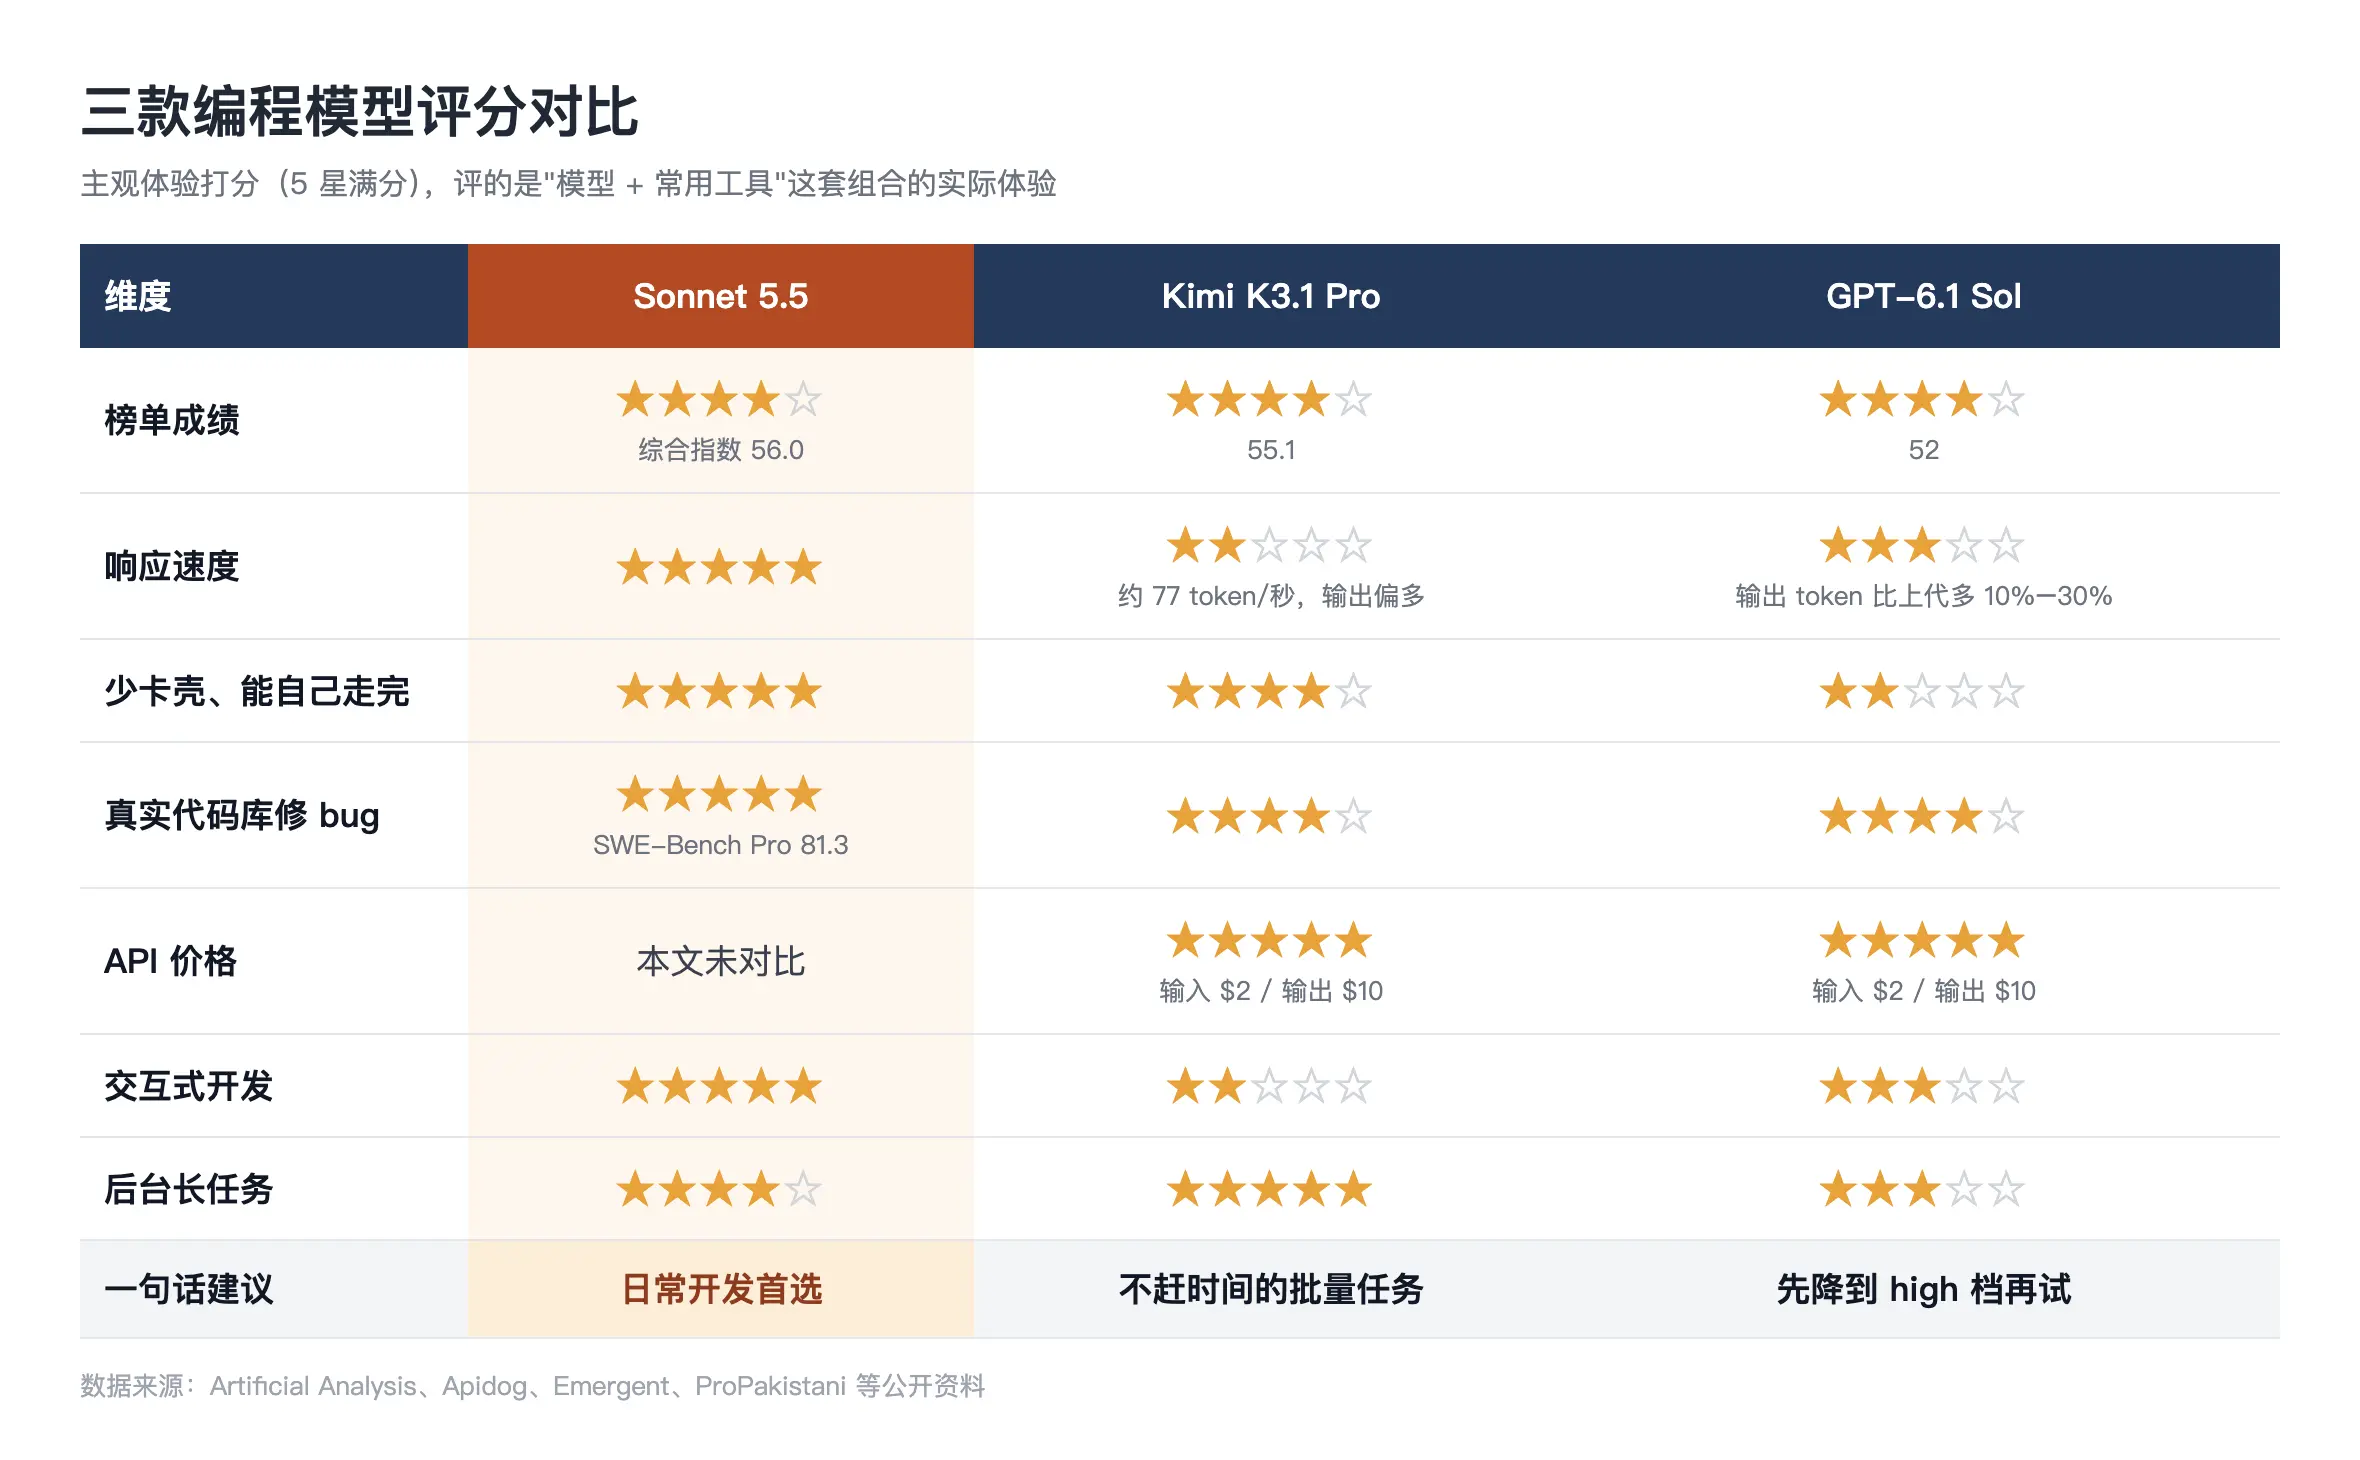
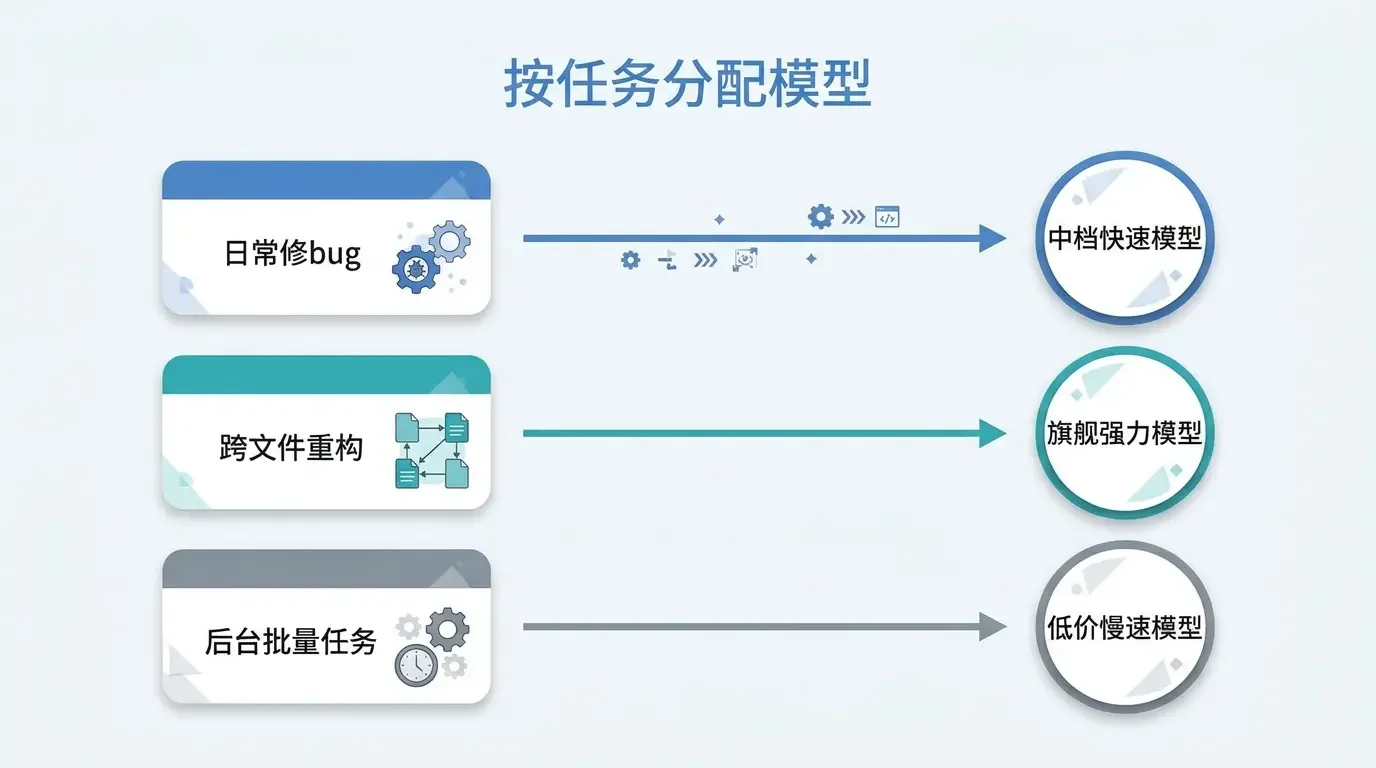
这几天我的日常开发基本都交给了 Claude Code 里的 Sonnet 5.5:修 bug、加接口、改前端页面、跨文件重构,都是真实项目里的活。用下来最大的感受就一个字:强。
• 又快又好:响应快,写出来的代码基本一次能用,很少需要返工;
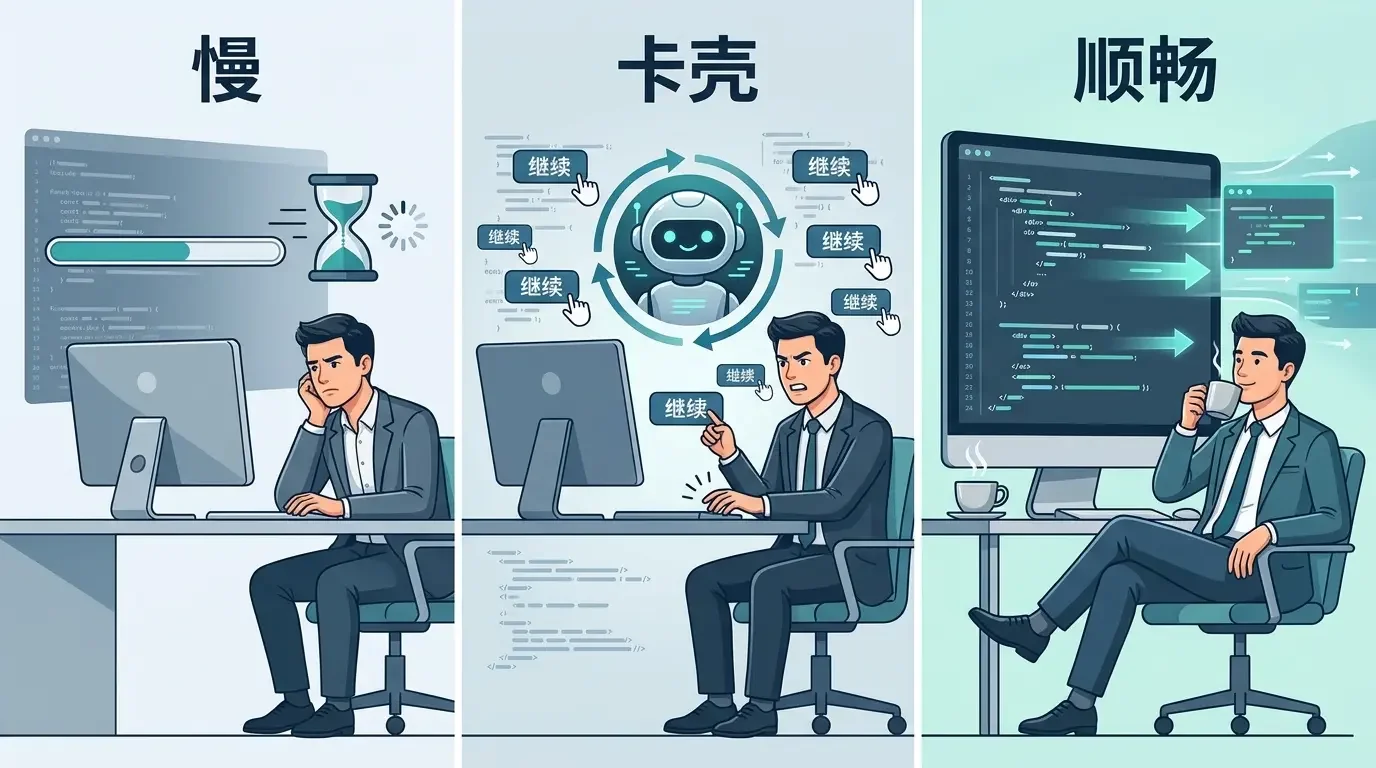
• 从不掉链子:任务交出去,它能自己一路做完,没遇到过做到一半停住、原地绕圈的情况;
• 非常抗用:高强度连着用一整天,额度依然够用,比 Kimi 抗用多了,不用一边写代码一边心疼额度。
更让我意外的是,Sonnet 5.5 在 Claude Code 里只是第三档的模型,上面还有更强的两档。
同样的活,我之前也交给过月之暗面的 Kimi K3.1 Pro 和 OpenAI 的 GPT-6.1 Sol,对比下来差距很明显。但这个结论和很多榜单并不吻合。三款模型都能在某张榜上找到自己的第一名,彼此差距也就几个百分点。问题在于,写代码不是考试:模型回得快不快、中途会不会停下来绕圈、要不要我一遍遍推它往前走,这些决定日常体验的东西,跑分一项都不统计。



 发表于