|
|
语音大模型的竞争,正在从"能不能把文字念出来"换成"能不能真正理解声音、组织声音"。阶跃星辰今天放出的 StepAudio 3 系列,就是冲着这个方向去的——五个模型一次全发:Realtime、ASR、TTS、Gen、Music。
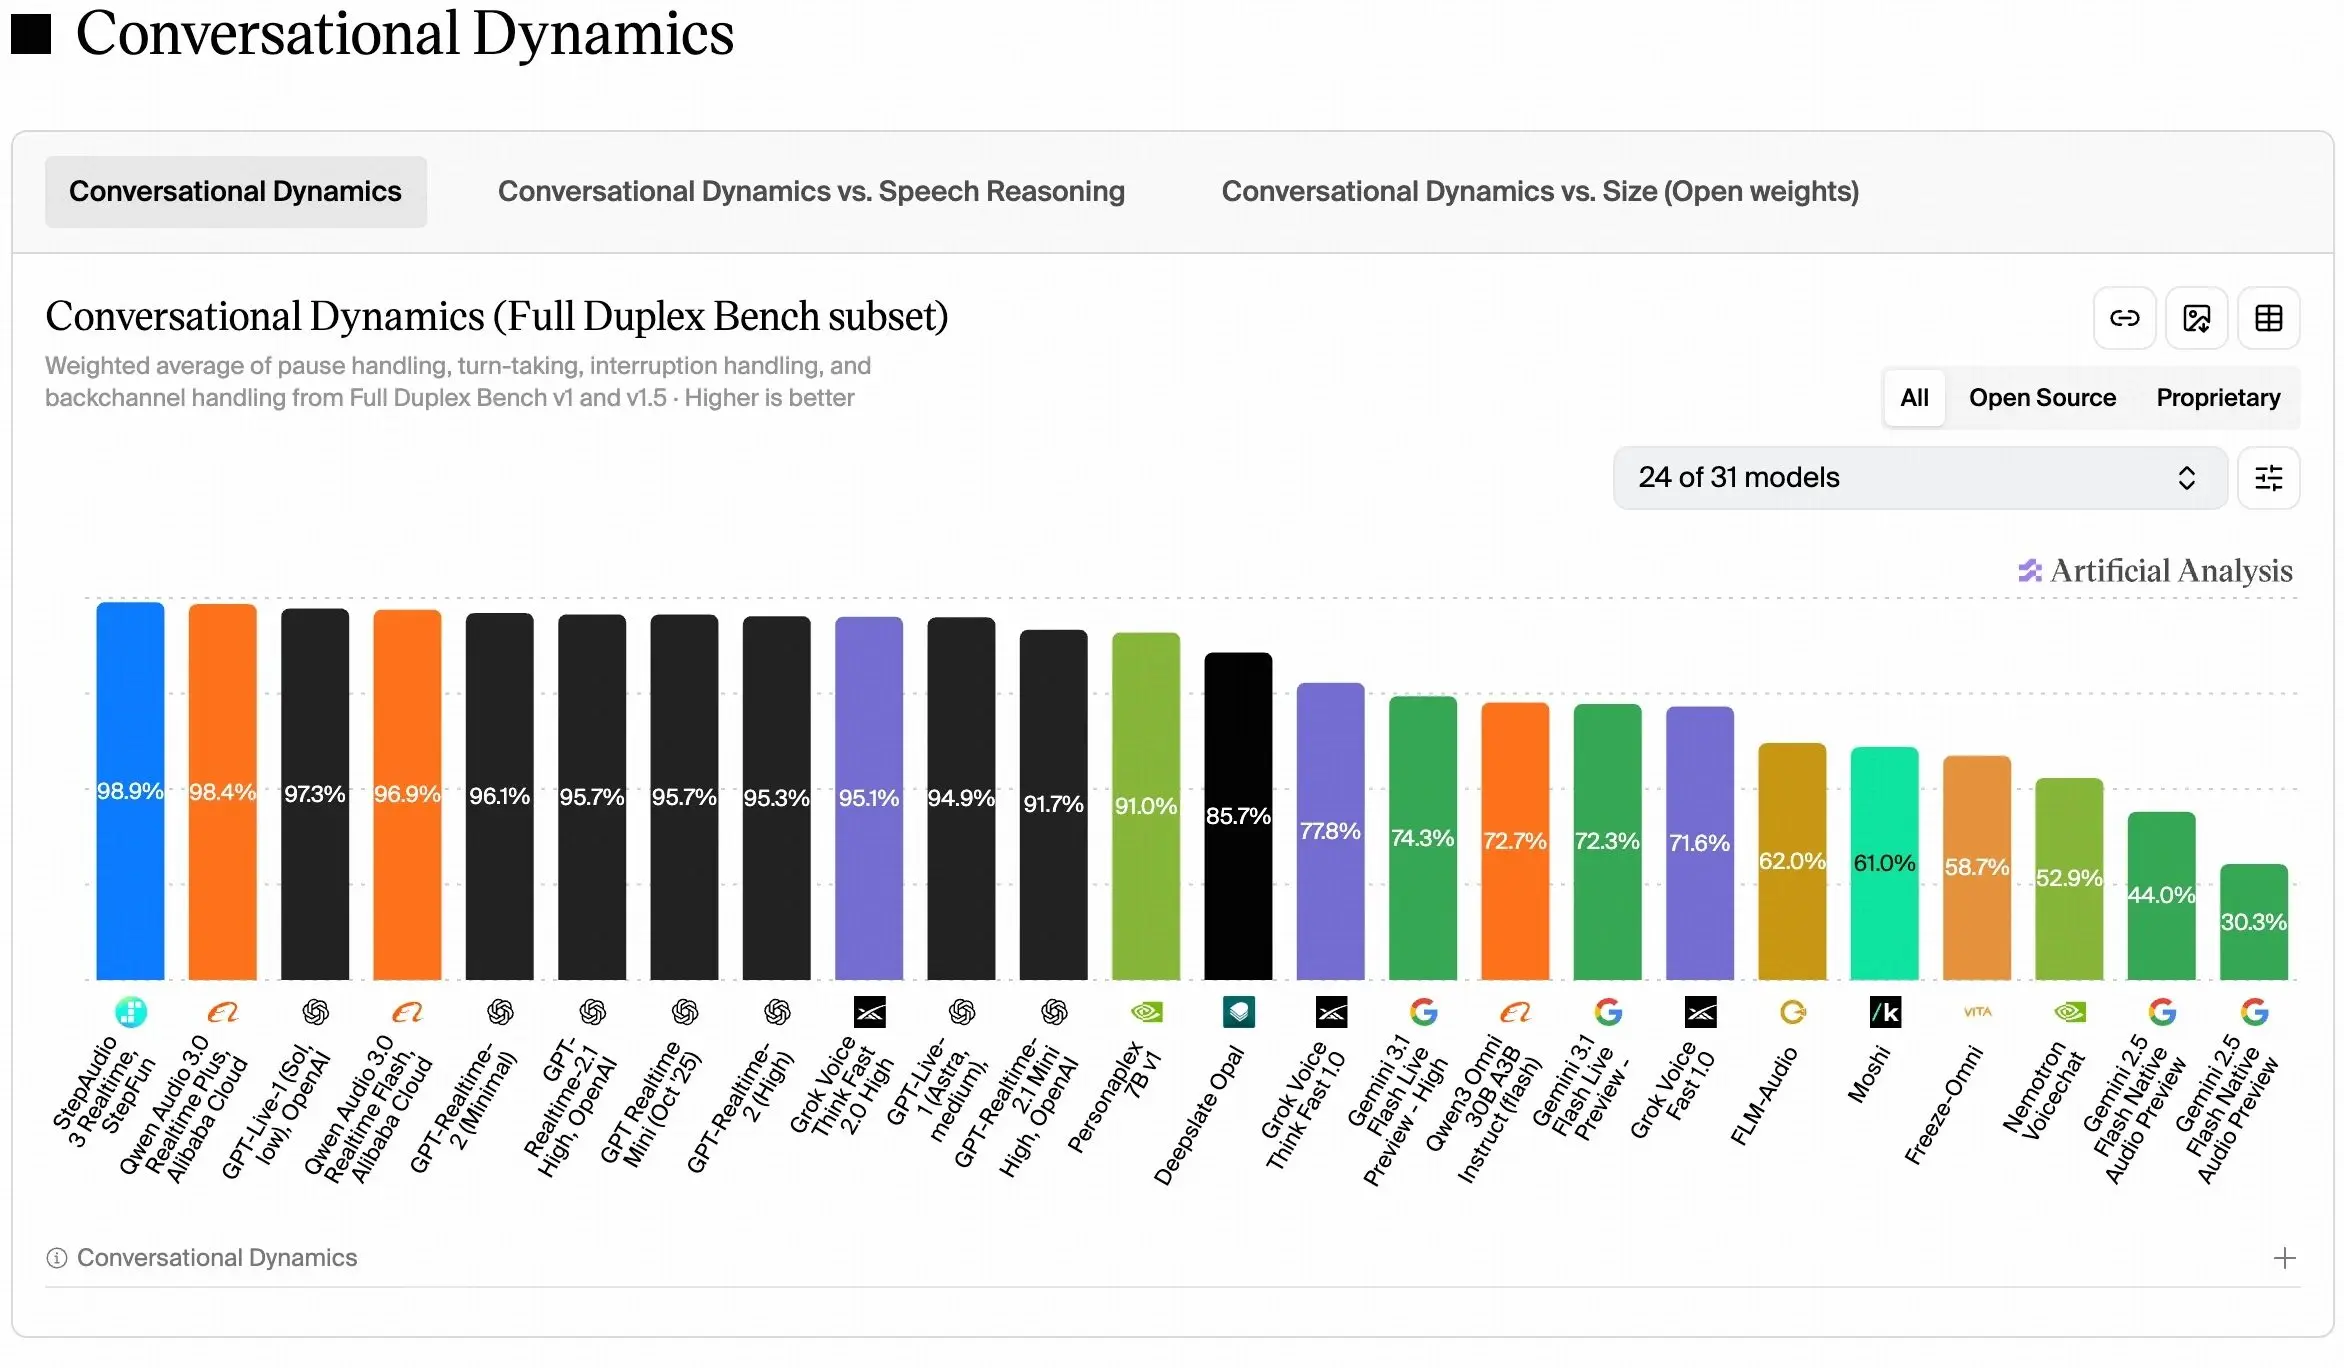
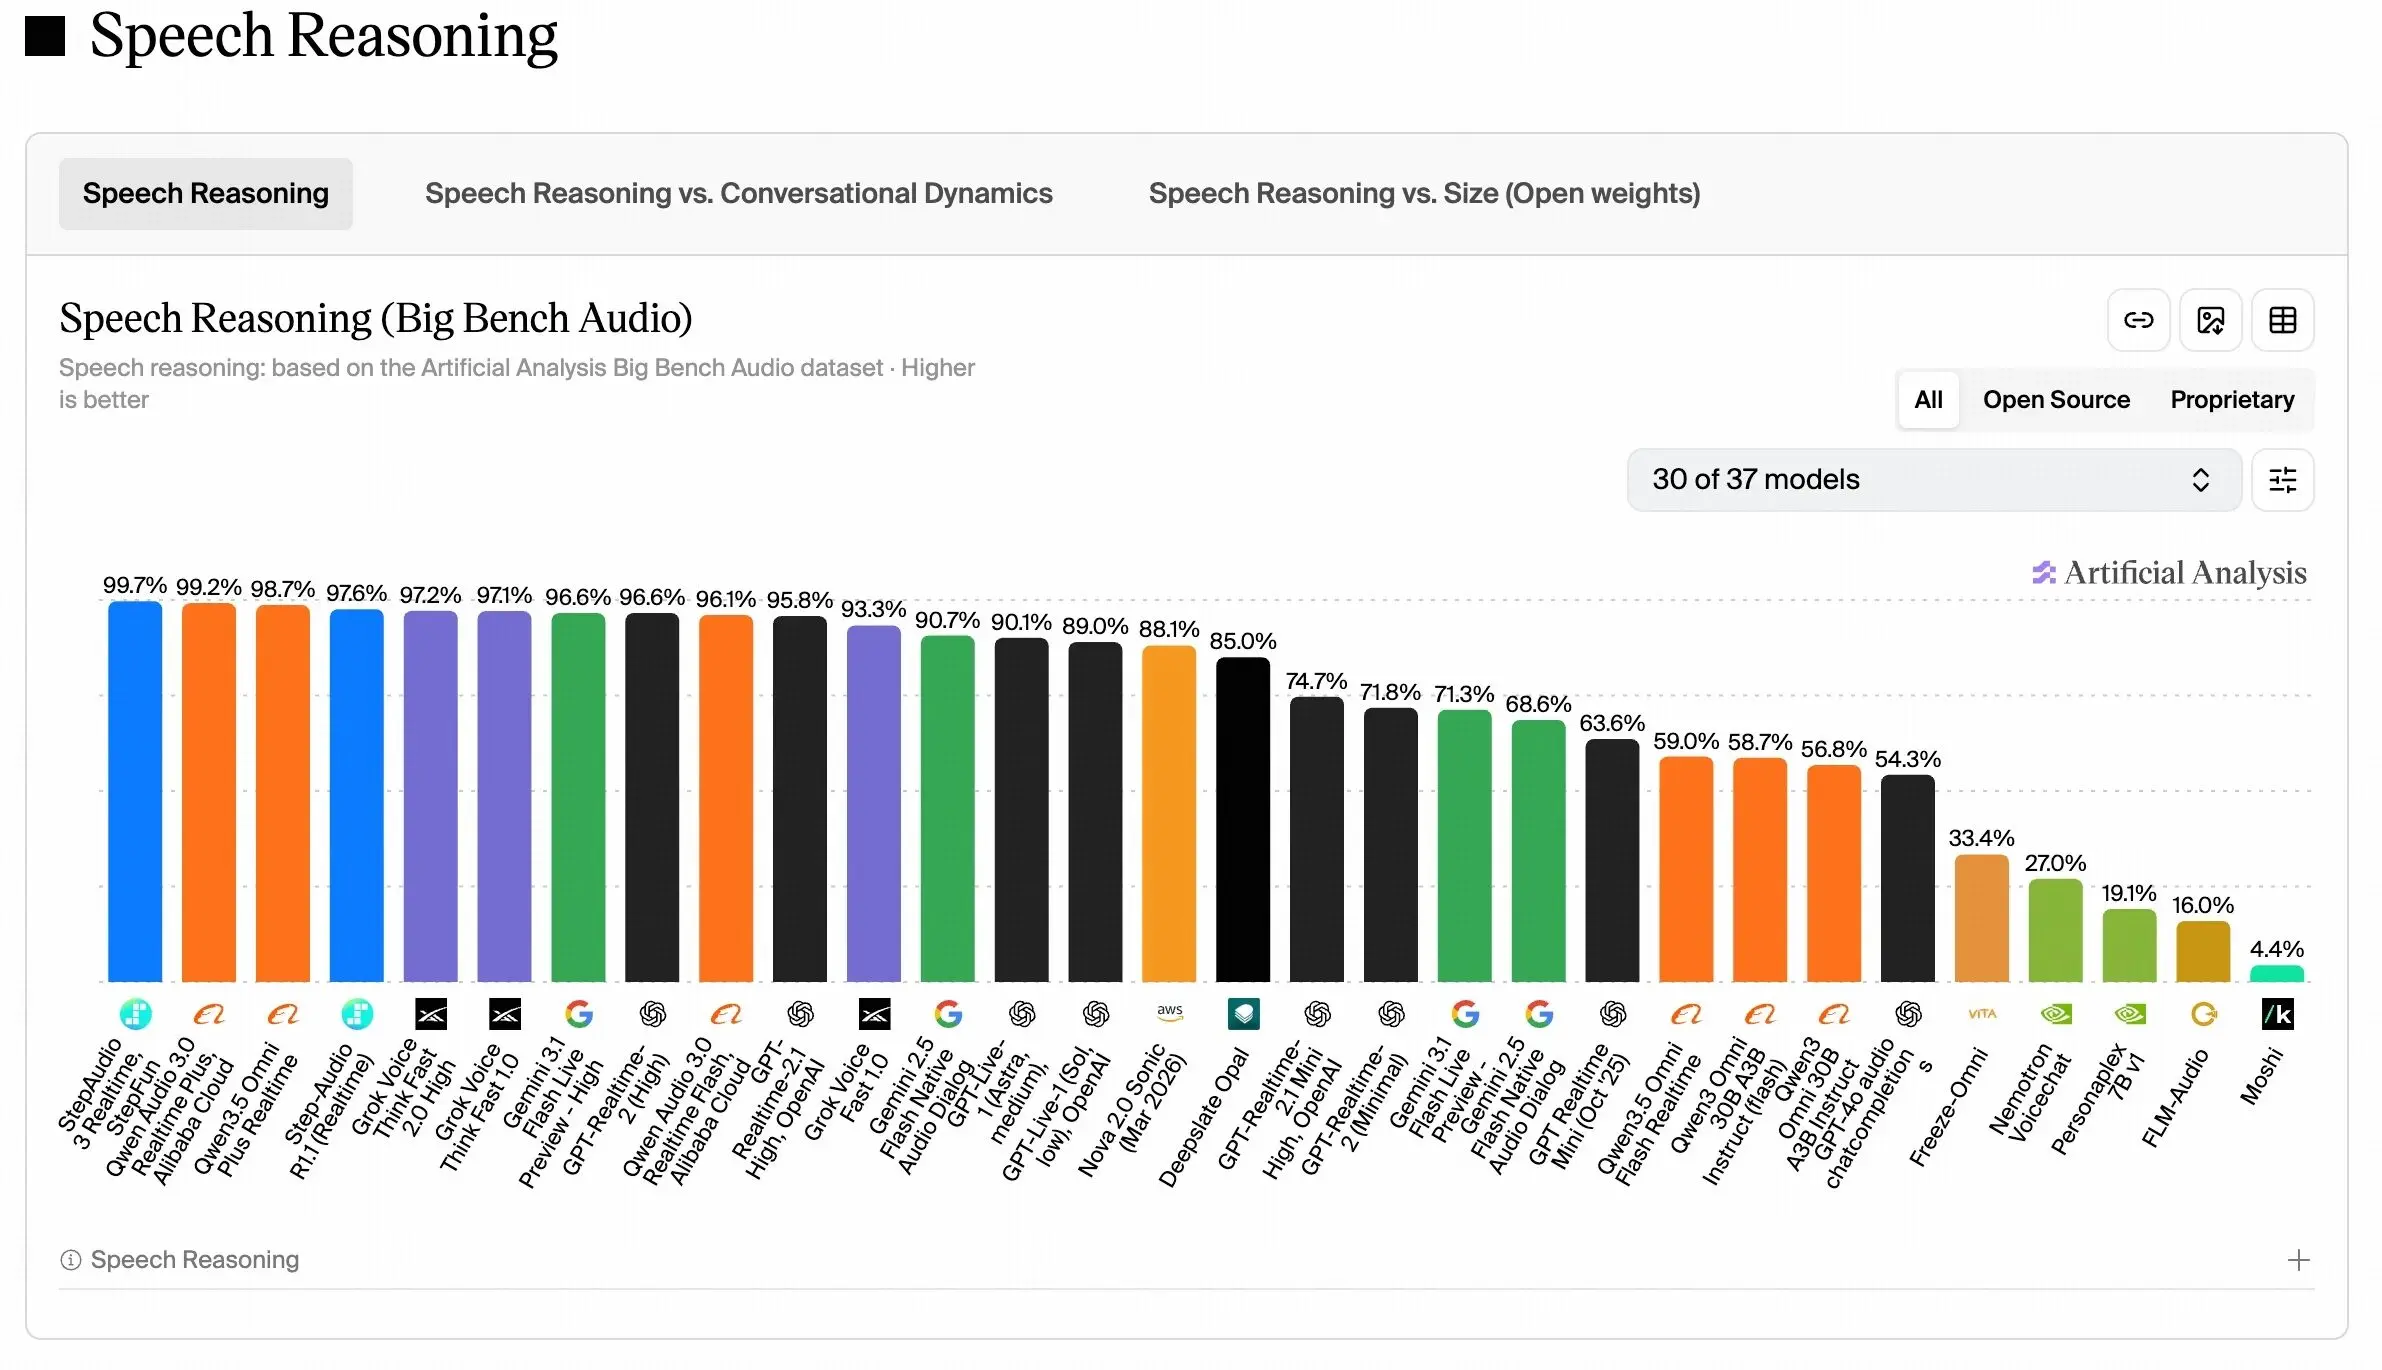
最出挑的是 StepAudio 3 Realtime。在 Artificial Analysis 的 Conversational Dynamics 榜单上,它以 98.9% 的综合得分排全球第一,语音推理准确率 99.7% 也在 Speech Reasoning 榜单登顶。相比"能听能说能打断"的全双工,这次更强调模型在一场持续对话里判断节奏——什么时候接话、什么时候等待,以及处理打断和连续反馈。推理和语音生成可以并行,工具调用和长任务异步执行,不阻塞当前会话。
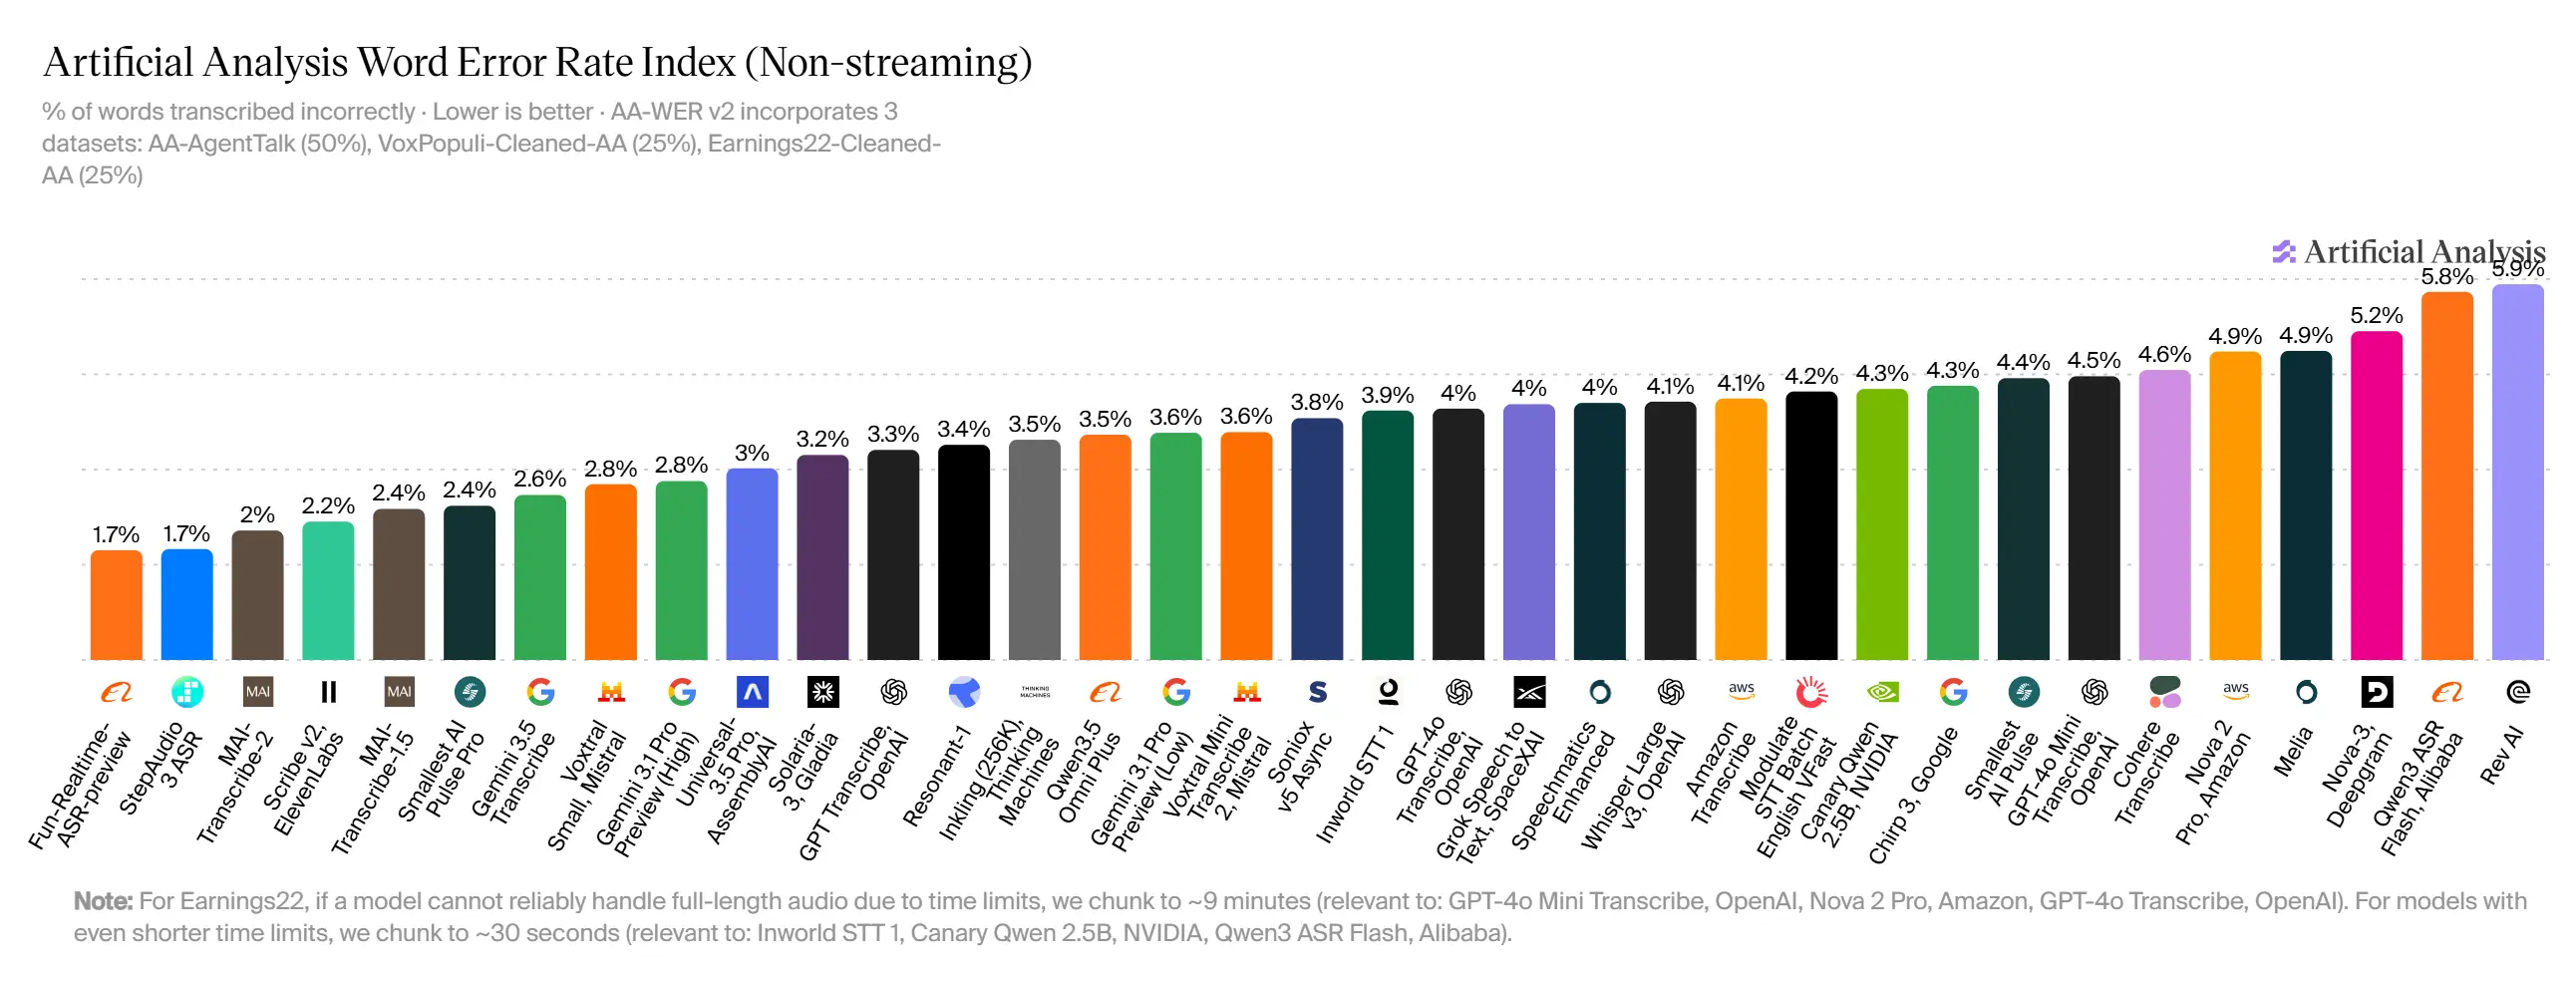
ASR 走的是"从听清到听懂"。它在高精度识别之外接了 LLM 的上下文理解,能处理方言、中英混说、专业术语,甚至在医疗、法律这类领域提升专业表达识别。非流式准确性榜单上 WER(词错误率)1.7%,并列全球第一。
TTS 追求的是"像真人表达"。模型除了生成对应语音,还能还原笑声、迟疑、结巴、重复、改口这些副语言表现——官方给的示例里有一段"要不要换工作"的独白,纠结、犹豫、改口全都在。
Gen 有意思的地方在于把原来分散的声音链路整个吞进去。角色配音、环境音、音效、背景音乐,不需要分头制作,靠自然语言描述和参考音频一次生成,还能控制多个角色的音色、语气、情绪和时间顺序。对影视、游戏、有声书创作者来说,原来需要素材搜集、多工具协作的流程,可能被压缩成一次生成加持续迭代。
Music 则明确打"不止生成,更参与创作"。支持 ABC 记谱法控制的多轮交互创作,用户给一段歌词、清唱或 Demo,模型接着完成编曲、改编和制作;基于清唱配乐时能理解旋律、节奏和情绪,再补上和声与完整编曲。
五款模型都已上线阶跃星辰开放平台,官方也放了各模型的 API 接入文档。
来源:
• 阶跃发布语音大模型 StepAudio 3,拿下多个全球第一!
原文链接 |
|



 发表于