0
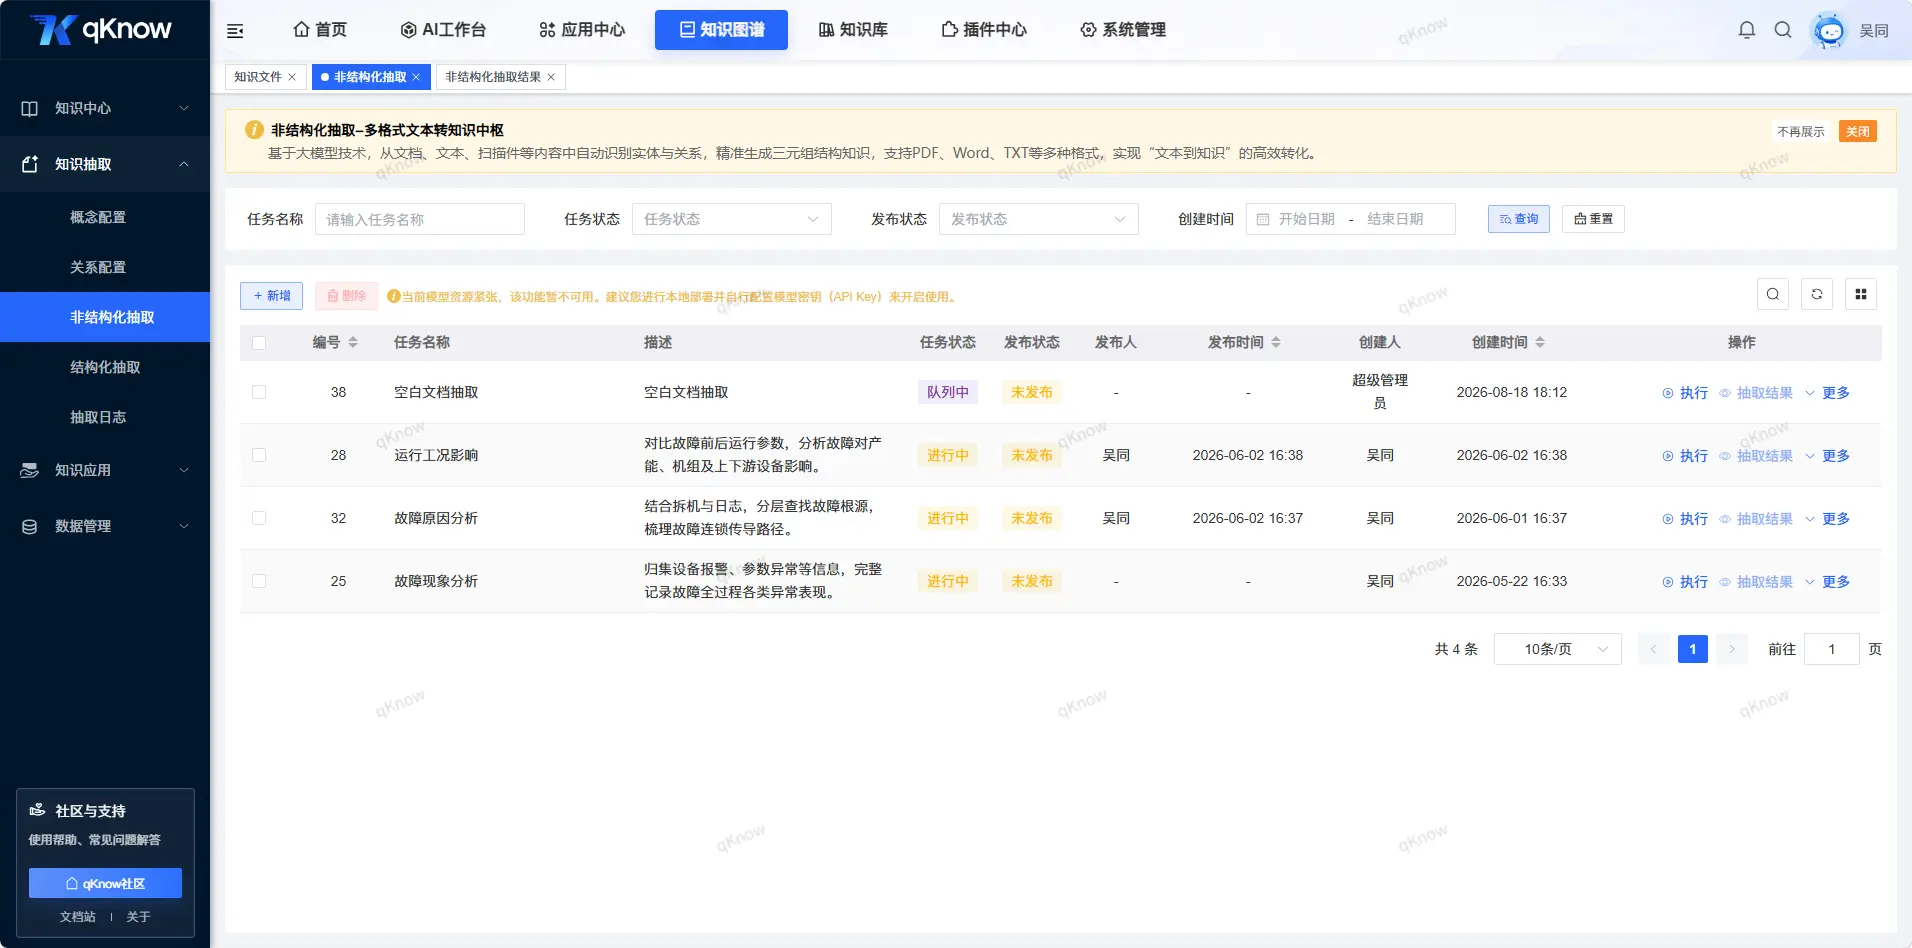
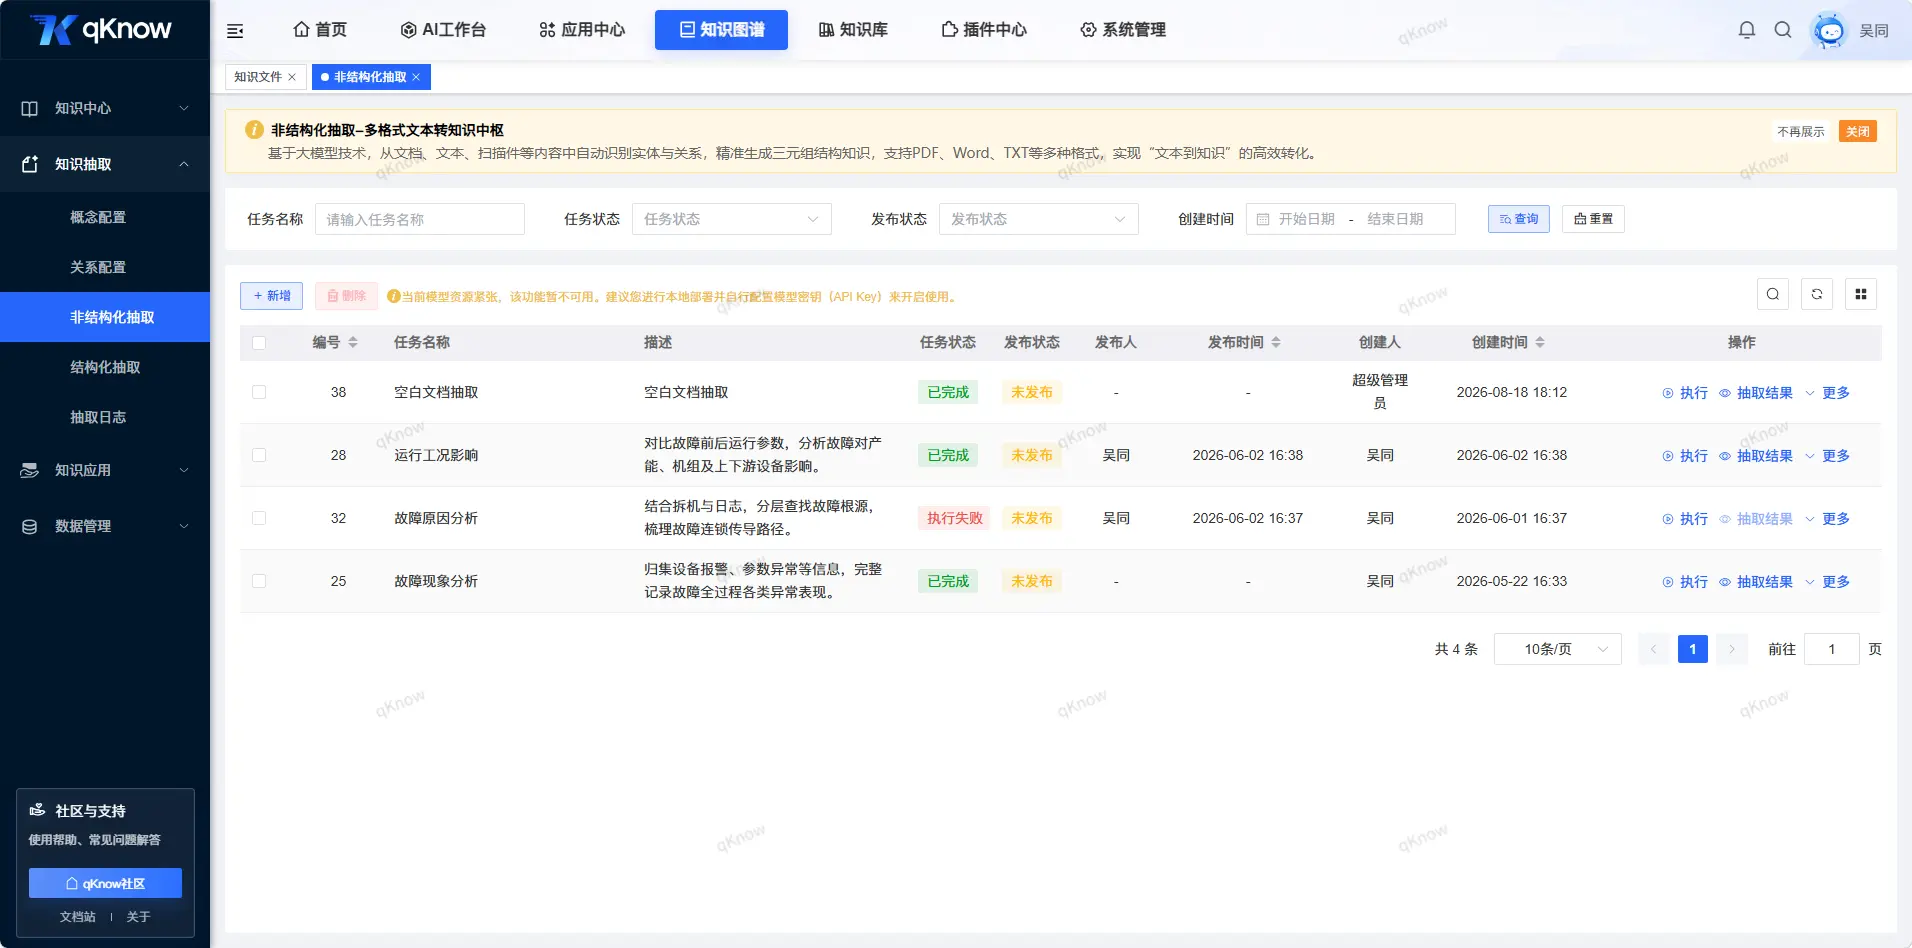
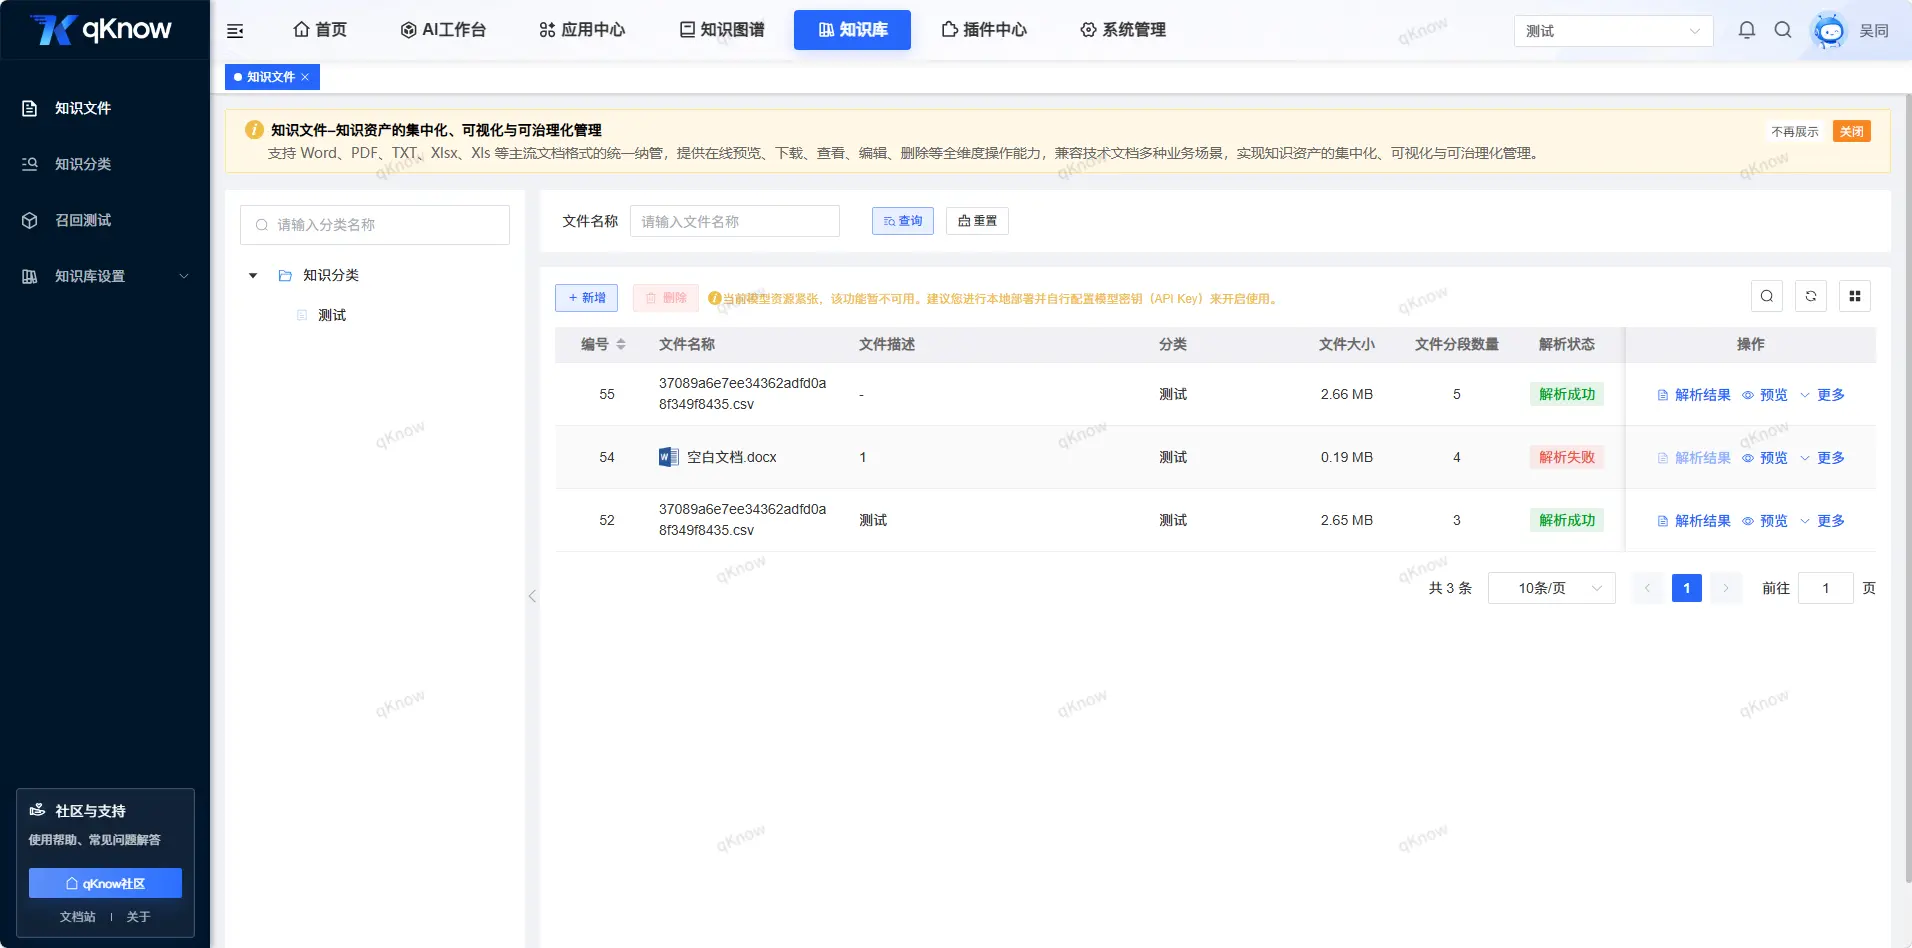
qKnow智能体构建平台开源版v2.4.1围绕非结构化抽取与知识文档解析逻辑进行优化,重点处理单个抽取任务失败影响其他任务、空白文档解析报错,以及批量解析过程中单个文件失败导致整批任务失败等问题,进一步提升知识文件处理过程中的稳定性与容错能力。
“这个文件能不能解析?”
一个文件失败,会不会影响其他文件? 一个空白文档,会不会直接触发任务异常?
任务之间是否彼此独立?
任务A失败 → 影响任务B / C继续执行
任务A失败 → 记录任务A结果 任务B继续执行 任务C继续执行
失败的是一个任务,而不是因为一个任务失败而扩大成多个任务的执行问题。
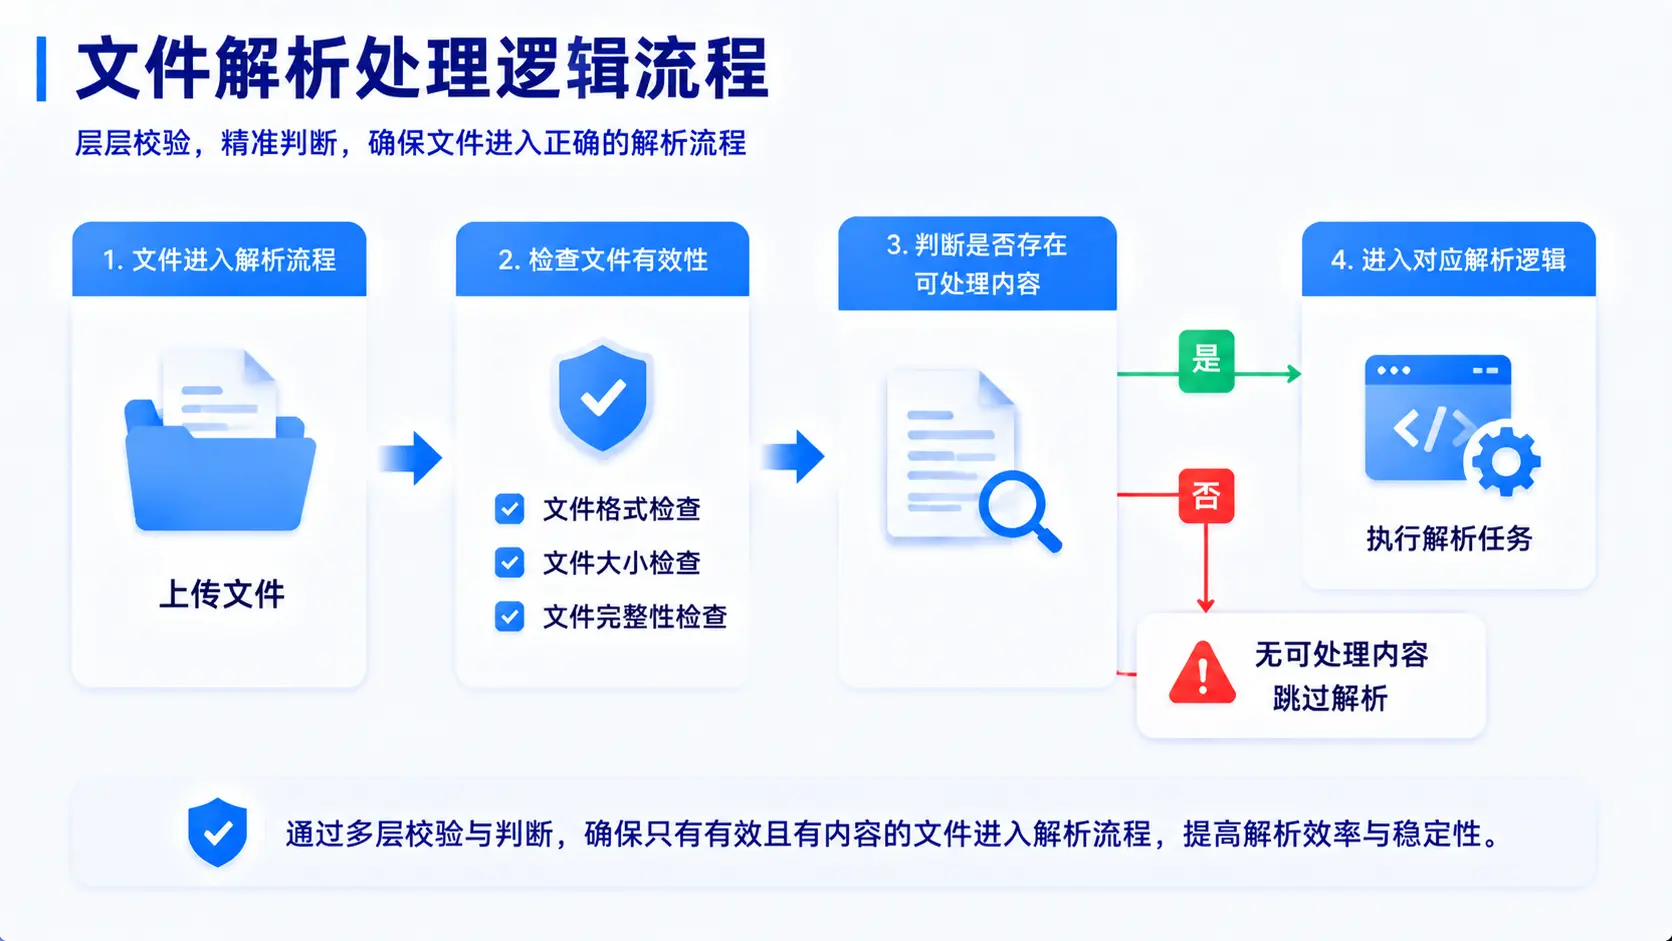
文件进入解析流程 → 检查文件有效性 → 判断是否存在可处理内容 → 再进入对应解析逻辑
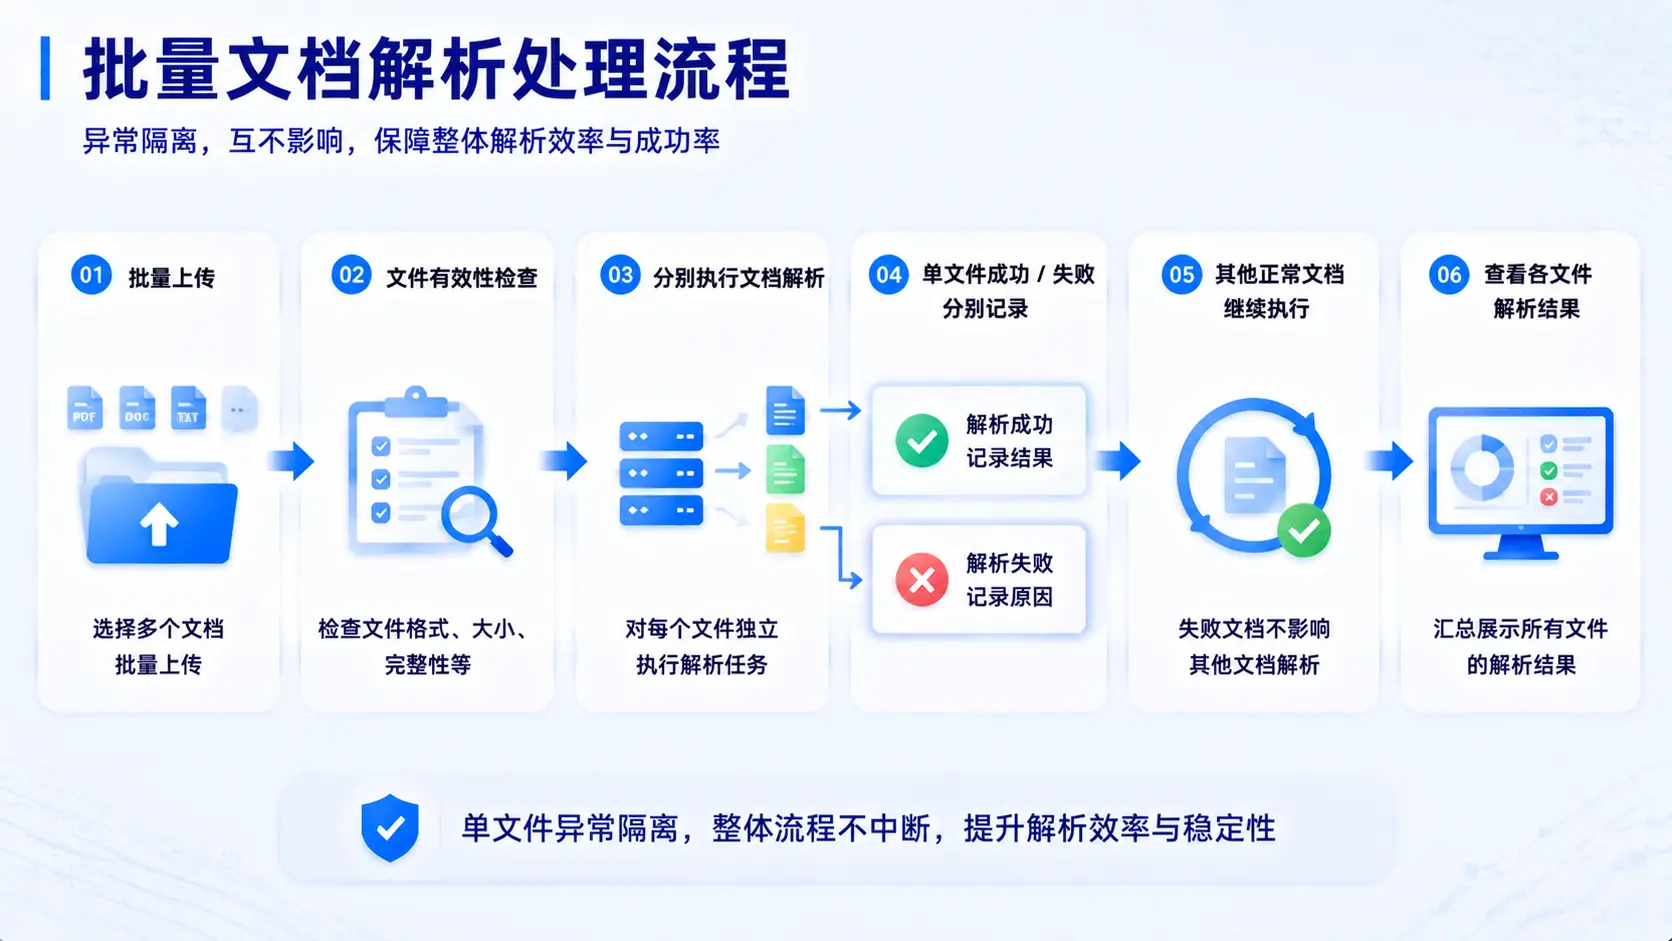
文件A + 文件B + 文件C + 文件D……
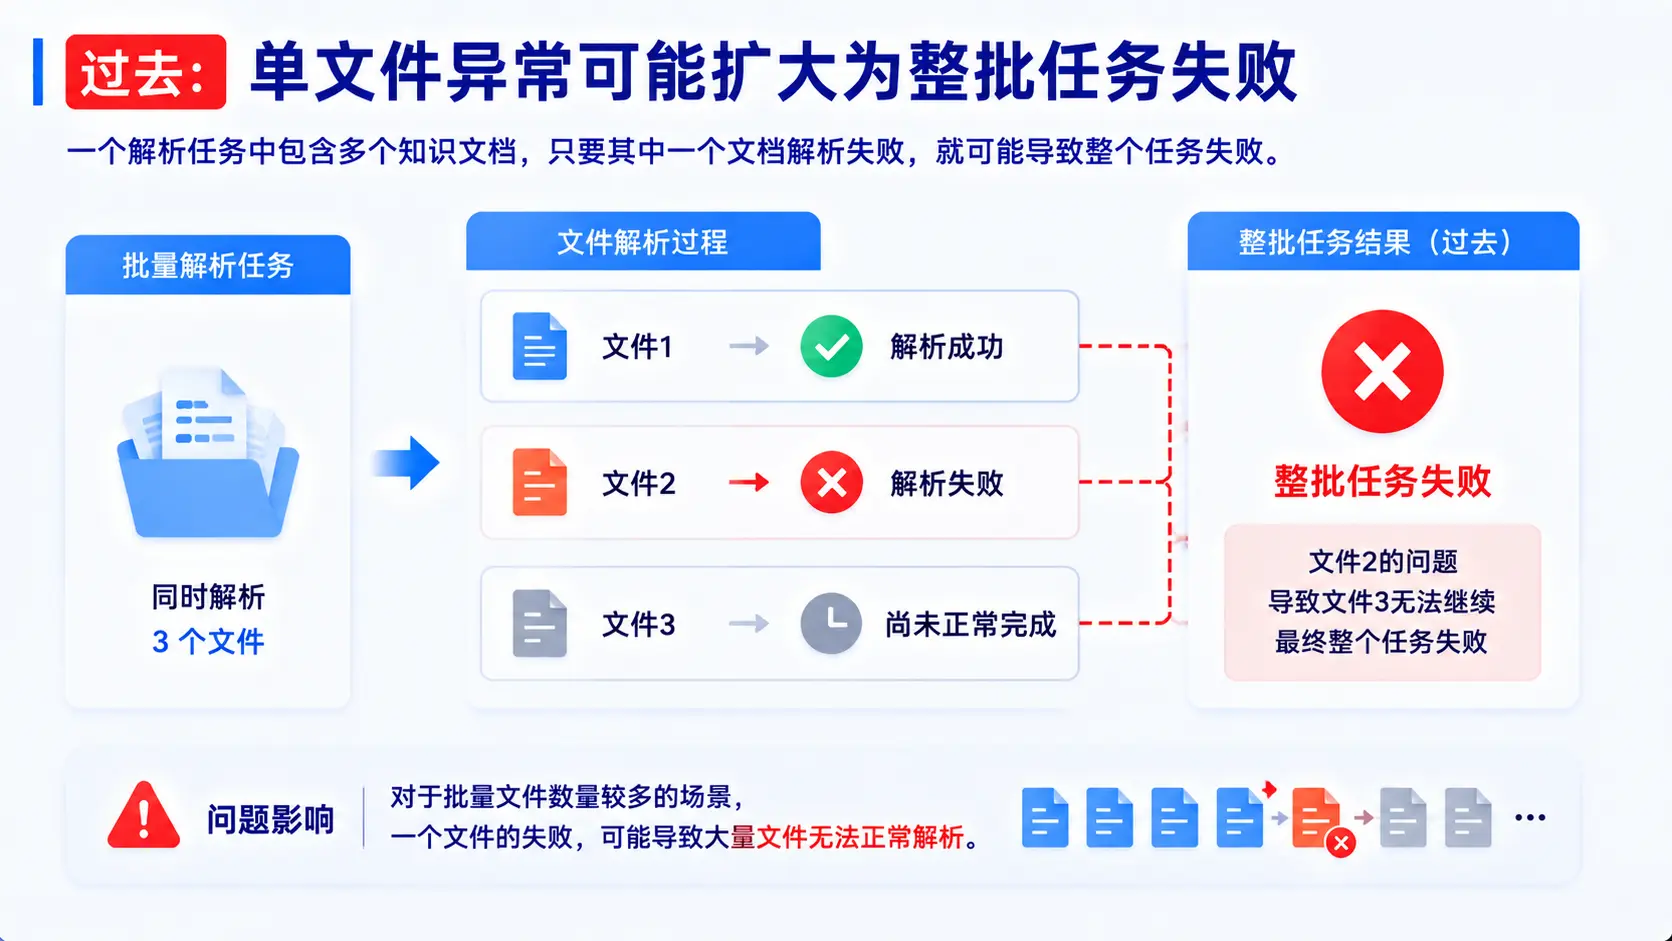
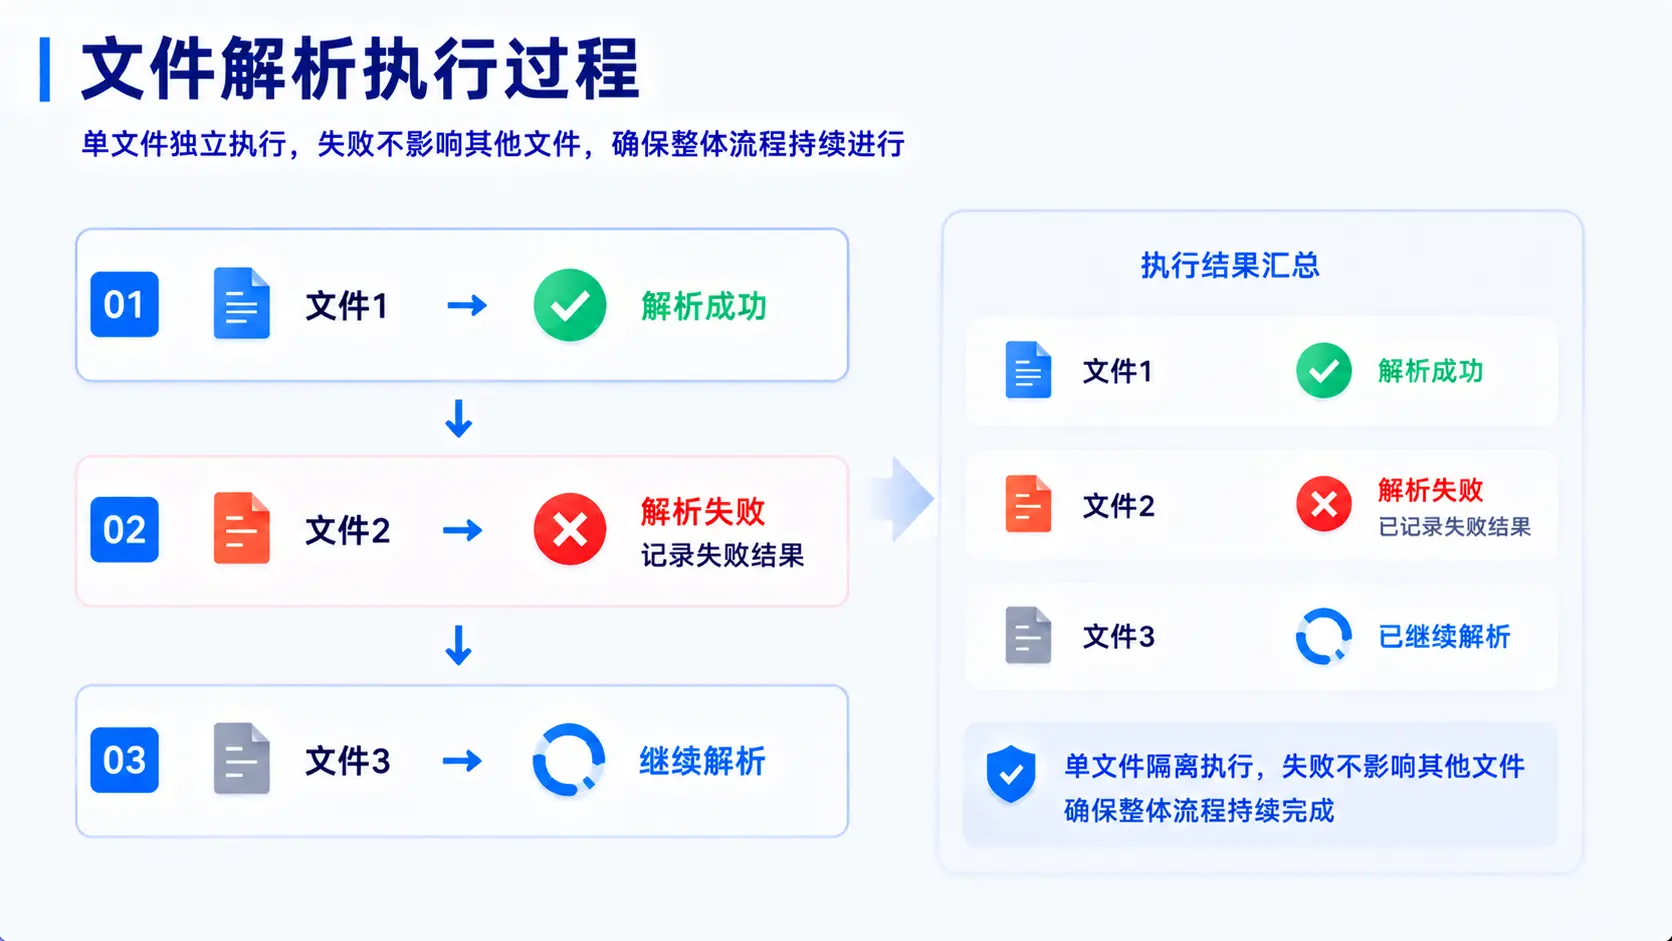
一个文件解析失败,应该只影响自己,还是让整批文件全部失败?
文件1 → 解析成功 文件2 → 解析失败 文件3 → 尚未正常完成
文件1 → 解析成功 ↓ 文件2 → 解析失败,记录失败结果 ↓ 文件3 → 继续解析
文件1 → 成功 ↓ 文件2 → 失败 ↓ 整个批次终止
整批共同成功 / 整批受到失败影响
逐文件判断、逐文件记录结果
当前文档记录失败 → 其他文档继续执行
批量上传 → 开始解析 → 某文件异常 → 任务受到影响 → 排查失败文件 → 重新确认其他文件状态
文件是否有效、文件是否解析成功,以及整个批次是否继续执行,被进一步拆分为不同层面的状态。
当一个文件出现异常时,平台应该尽可能准确地识别当前文件的问题,而不是让这个问题继续影响其他原本可以正常处理的知识。
举报
但随着企业知识资料不断增加,实际运行环境往往会复杂得多。
本版积分规则 发表回复 回帖后跳转到最后一页



 发表于 2026-8-26 14:01:01