|
|
"让模型直接写 SQL"这条路,大概率行不通;而"把确定性还给平台、还给工作流"这才是可行的路径。
YOLO Data 将大模型 DataAgent 、实时指标体系、业务数据集、数据权限、会话记忆和工作区产物整合为一条可审计、可复现、可治理的workflow。业务可以对同一个问题进行多轮追问,当模型对口径需要用户澄清时进行反问。YOLO Data 是面向企业指标语义的智能问数平台。
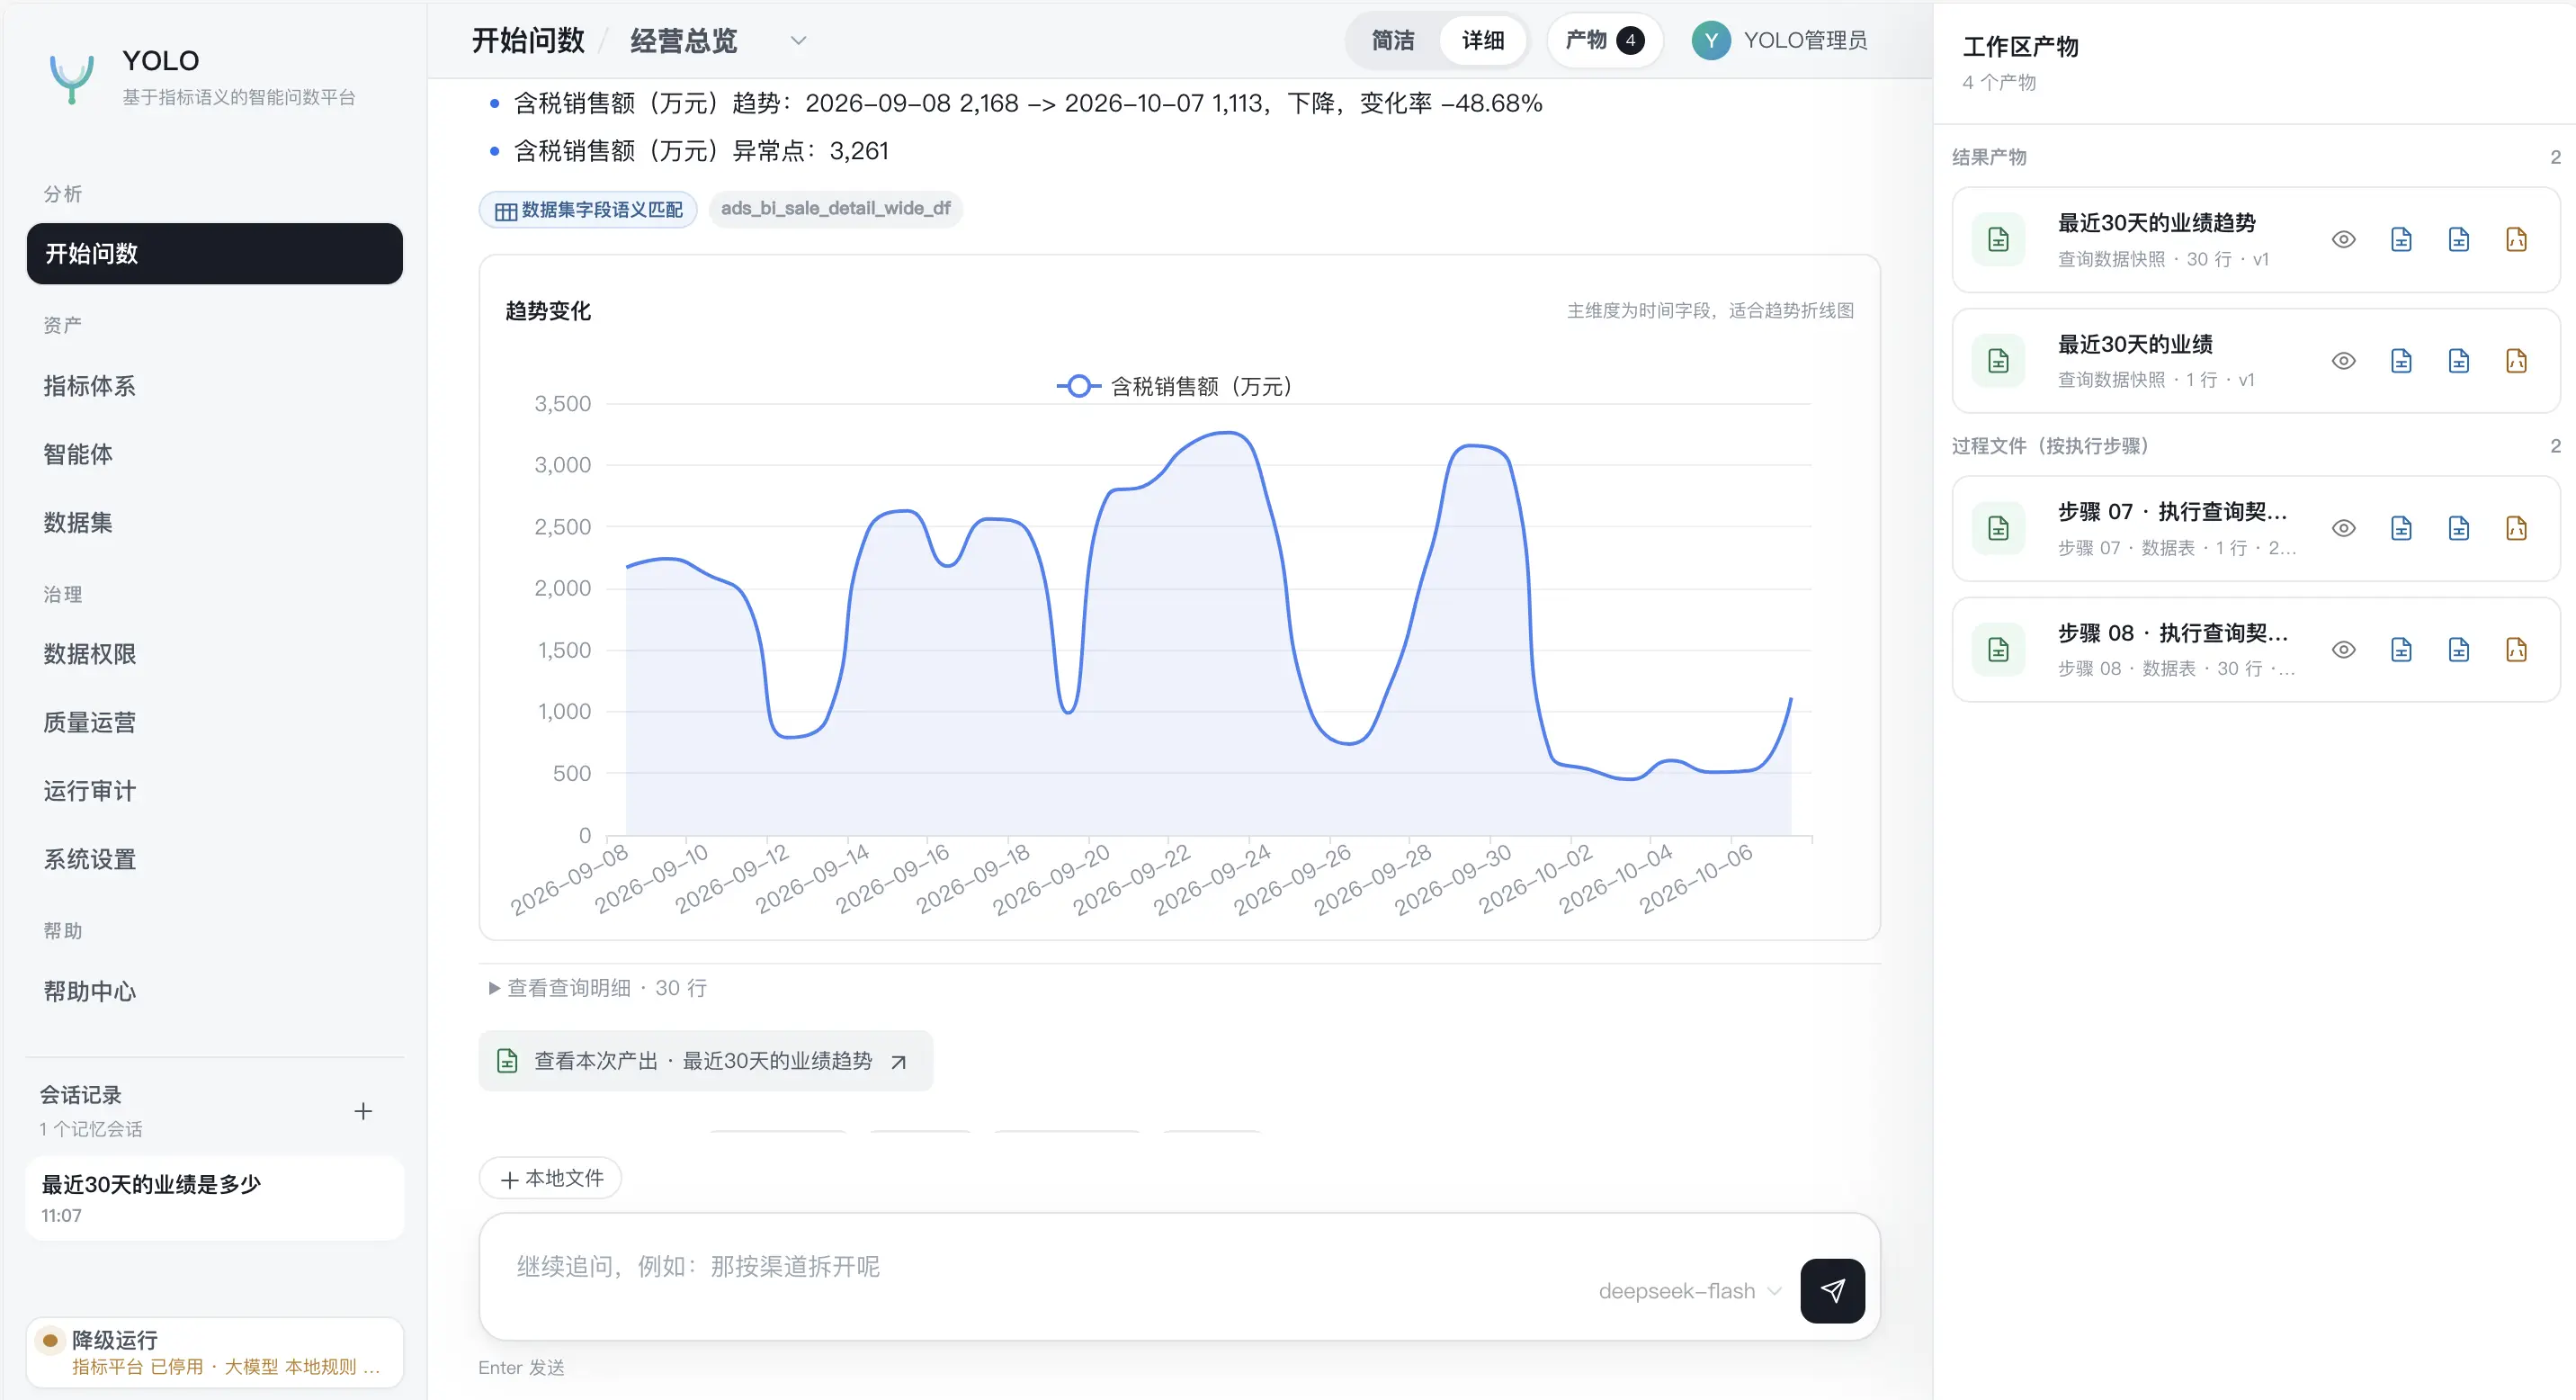
主要解决的问题
•
Text2SQL每次回答不一致,答案随机性强
•
语义层不统一,业务各说各话
•
现有组织架构数据处理“出数>归因>决策>执行”流程过长
项目定位
•
企业数据问数不只依赖大模型自由生成 SQL。YOLO Data 采用 Contract-first 架构:
•
模型负责理解业务问题、指标口径和字段候选。
•
平台负责时间解析、字段映射、查询契约、权限绑定和结果稳定化。
•
最终查询只能从已治理的指标或业务数据集中执行。
•
所有关键步骤保留证据,可审计、可复现、可回放。
核心能力
1.
对接指标目录、指标详情、口径、维度和聚合查询。
2.
每个主题独立配置提示词、模型、Skills、指标范围、数据集范围和默认口径。
3.
一个主题就是一个独立的业务 DataAgent。
4.
模型新增、编辑、删除、温度、工具轮次和平台默认模型管理。
5.
主题可以绑定多个模型,并指定默认运行模型。
6.
支持 Doris 或 MySQL 兼容数据源。
7.
平台根据字段语义生成只读查询,不向模型暴露原始 SQL。
8.
支持字段同步、抽样、默认枚举值域和数据集查询审计。
9.
支持「智能识别」:抽样数据自动推断时间字段、常用指标与默认时间窗口,管理员确认后写入字段口径。
10.
Contract-first 契约先行查询,查询契约冻结后才允许执行。
11.
自然语言被编译为条件账本和查询契约。
12.
时间范围、权限、排序和结果行序由平台确定性处理。
13.
主题级、指标级、数据集级授权,行级策略强制覆盖模型同字段条件,列级策略支持隐藏和脱敏。
14.
会话记忆与长期记忆均按用户和主题隔离;长期记忆沉淀成按「用户 × 智能体」的 Markdown 手册,注入摘要、按需检索正文,并自动合并笔记、压缩超长正文。
15.
查询结果、代码执行结果、CSV、JSON、XLSX 输出均保留为工作区产物。
16.
追问优先复用已有数据快照,避免重复取数造成结果漂移。
17.
支持标准 SKILL.md 目录扫描和安装。
18.
支持规划前审计、规划约束、执行后结果验证。
19.
十二阶段 DataAgent Workflow。
20.
流式执行事件、工具调用、查询计划、LLM Token、反馈和知识缺口。
21.
提示词用于展示效果或结论能够按照业务要求自由定义。
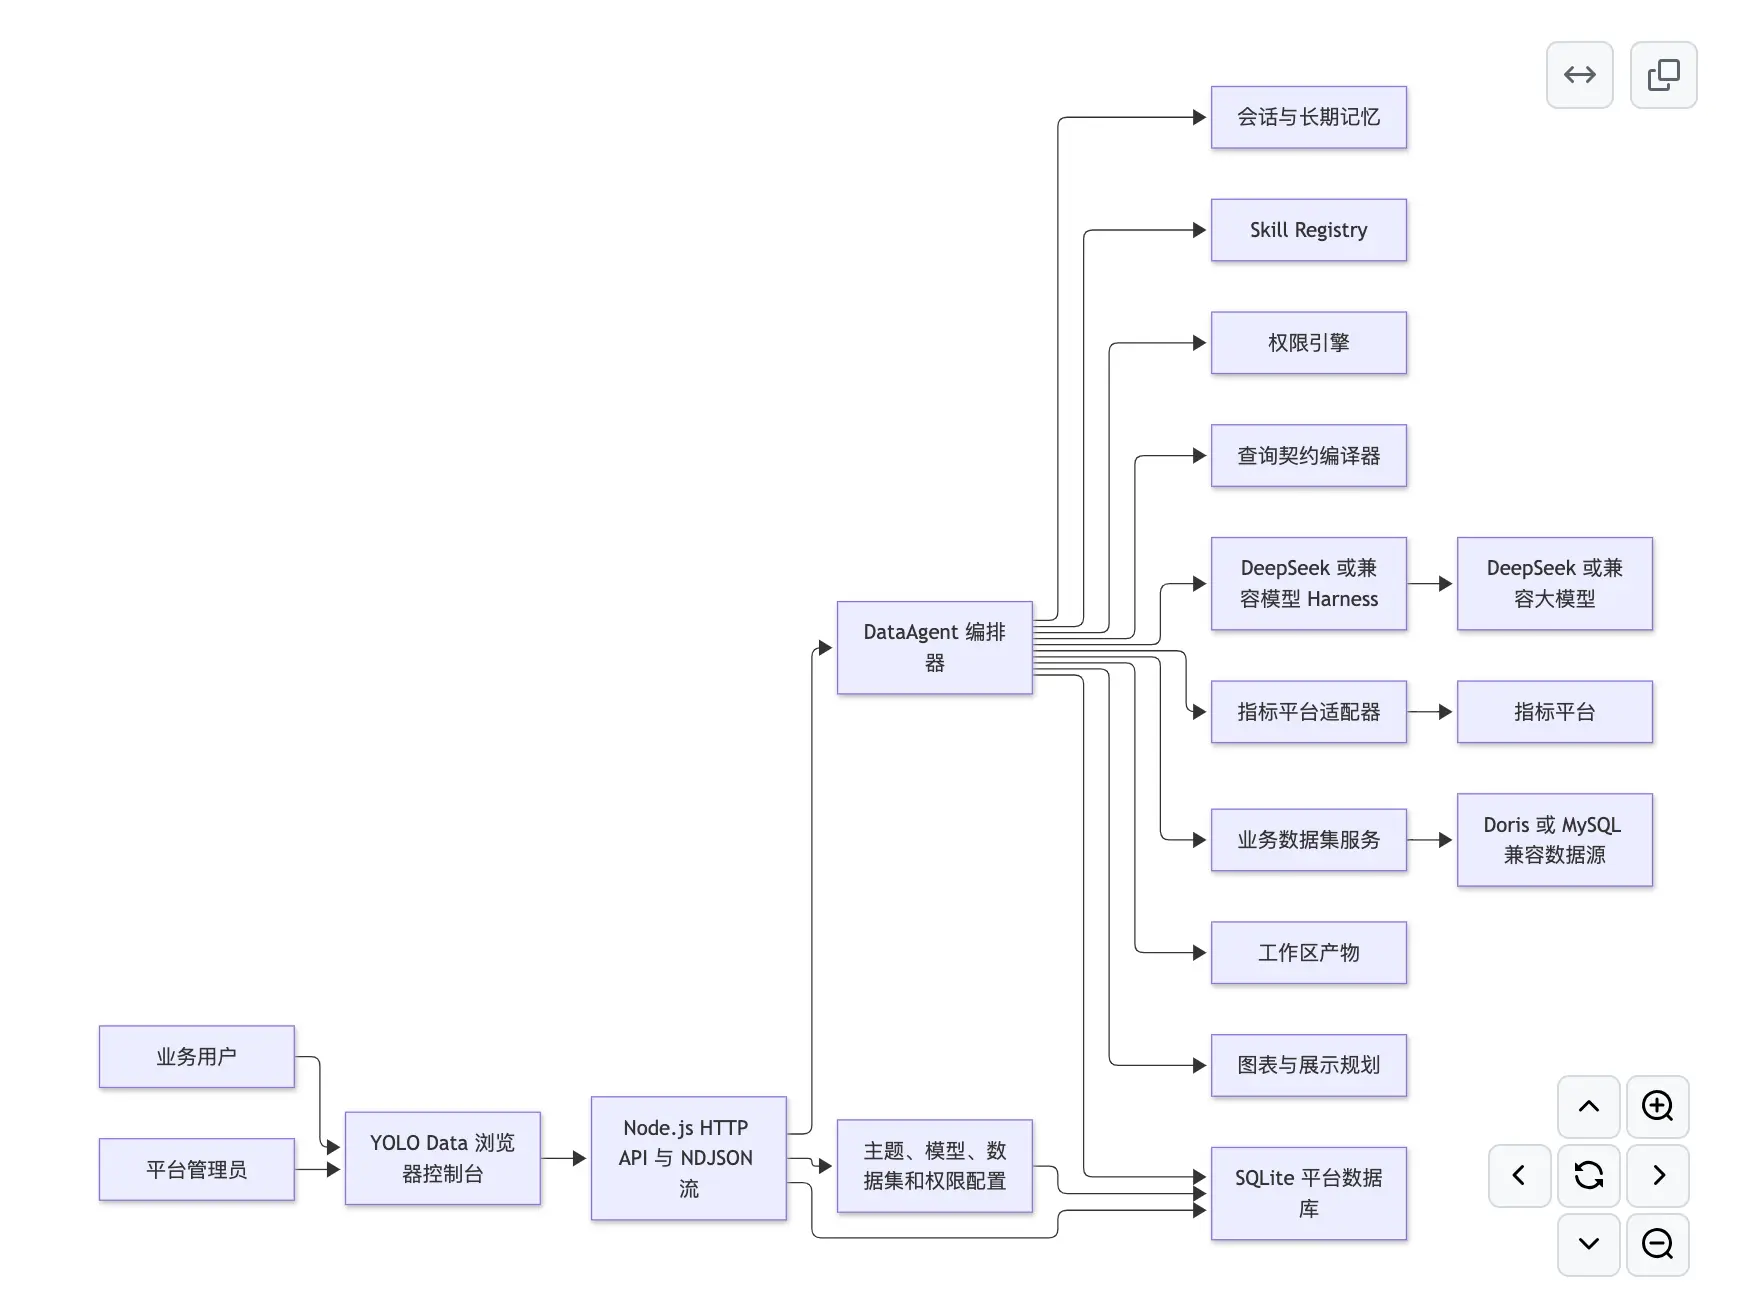
总体架构
仓库地址:
- gitee:https://gitee.com/xiaour/yolo-data
- github:https://github.com/xiaour/yolo-data
欢迎start和快速部署使用。
原文链接 |
|



 发表于 2026-10-9 12:30:30