|
|
git.kernel.org 每天接收到 600 万个请求在查看随机的 git 提交,但其中 98% 不是来自“人类”。
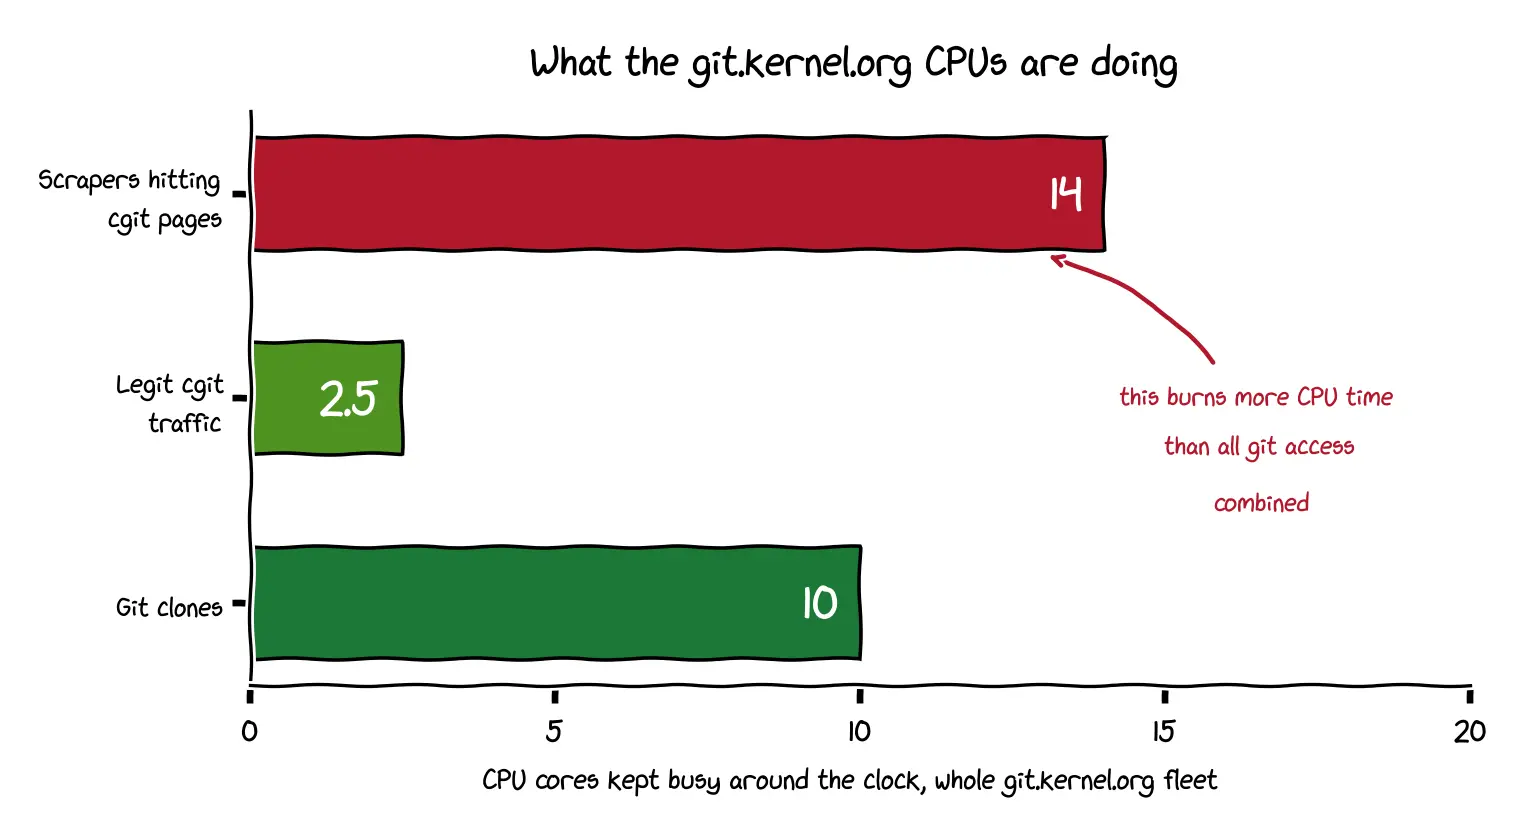
Linux 内核维护者 Konstantin Ryabitsev 在 kernel.org 官方博客里写了一篇《Creepy crawlies》,把他抱怨了很久的 AI 爬虫问题,第一次用具体数据摊开。那组数字让人很难不在意:为了让爬虫把内核提交渲染成 HTML,五个地理分布节点上始终有 14 到 16 个 CPU 核心在满负荷运转,什么都不干,就做这一件事。而所有合法访问——包括真正的 git clone——消耗的算力加起来,都比不上这群爬虫。
Ryabitsev 的愤怒里藏着一点黑色幽默。Linux 的开发是完全开放的:git 仓库可以克隆,邮件列表讨论可以实时追踪。对 LLM 来说这是训练数据的金矿,因为内容不仅立刻能拿到,而且经过时间验证——"用 LLM 生成的内容训练 LLM,等于给它喂数字朊病毒",所以像内核提交历史这样保证不含 AI 痕迹的来源,价值连城。
问题在于,爬虫选择了最愚蠢的获取方式。
linux.git 有 148 万条提交,git.kernel.org 上还挂着 922 个 fork。后端的存储是高效的去重对象,但爬虫不懂这个。它把每一个提交都渲染成 HTML 再解析,去爬取几十亿个有效 URL——一份 148 万条提交的内容,被重复抓了 922 遍。仅一个 fork 就能展开成天文数字级的 URL:补丁页、纯文本渲染、任意两个提交之间的 diff,全都是独立地址。
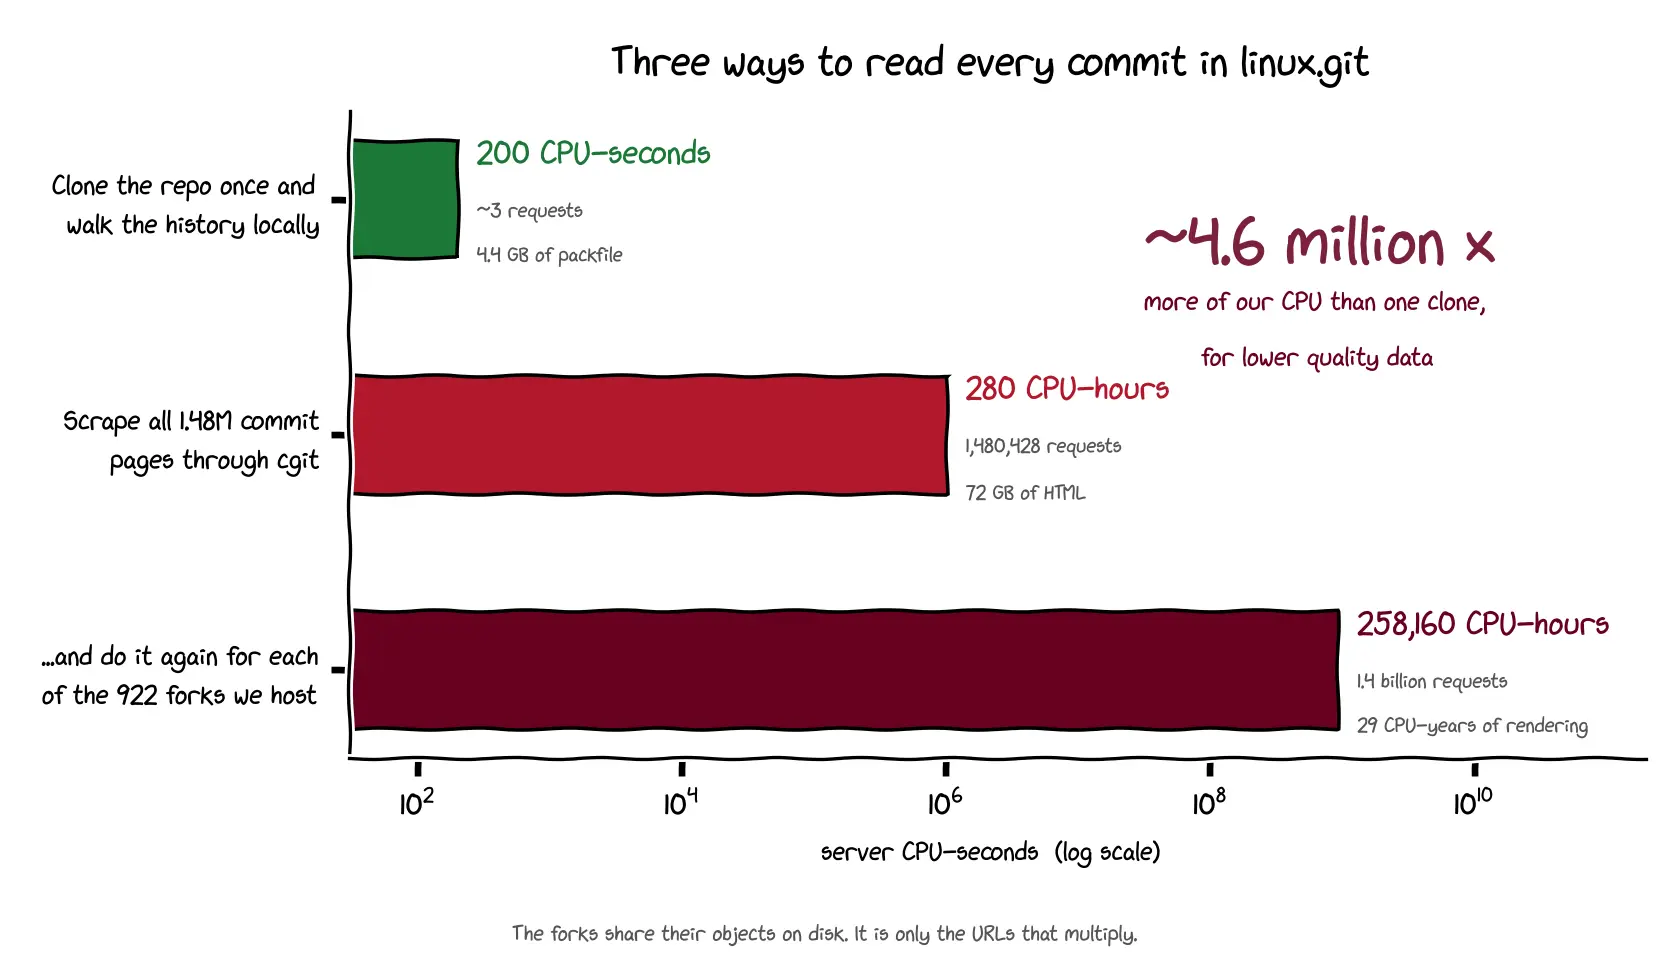
Ryabitsev 的原话带了点情绪:"你总以为一个自称'人工智能'的东西,会用最高效的方式消耗我们的数据来训练吧?克隆仓库,遍历提交,完事。"结果没有。爬虫不管这个流程是不是合理,它只是把整个互联网当 HTML 来爬。
封锁的演化过程读起来像一场军备竞赛。第一阶段靠日志找 IP,用 fail2ban 封禁——那时爬虫还老实,user-agent 里自报身份。第二阶段爬虫开始伪装成随机浏览器,团队发现它们会去访问废弃多年的旧 fork 里的提交,这是人类绝不会做的事,于是改成按 IP 封、甚至封整个 ASN。第三阶段最绝望:爬虫来源变成了数百万个随机的住宅 IP 和移动 IP,全部伪装成现代浏览器,每个 IP 只发四五个请求就消失,"等你反应过来它们是机器人的时候,它们已经完事了"。
这些住宅 IP 从哪来的?Ryabitsev 指向一个叫"代理 SDK 货币化"的生意——你的智能电视、机顶盒、路由器,很可能就在后台把这些请求转发出去。他引用的那篇调查报告标题直白:《Smart TV Apps & Residential Proxy SDKs》——"你家电视也在干这个"。
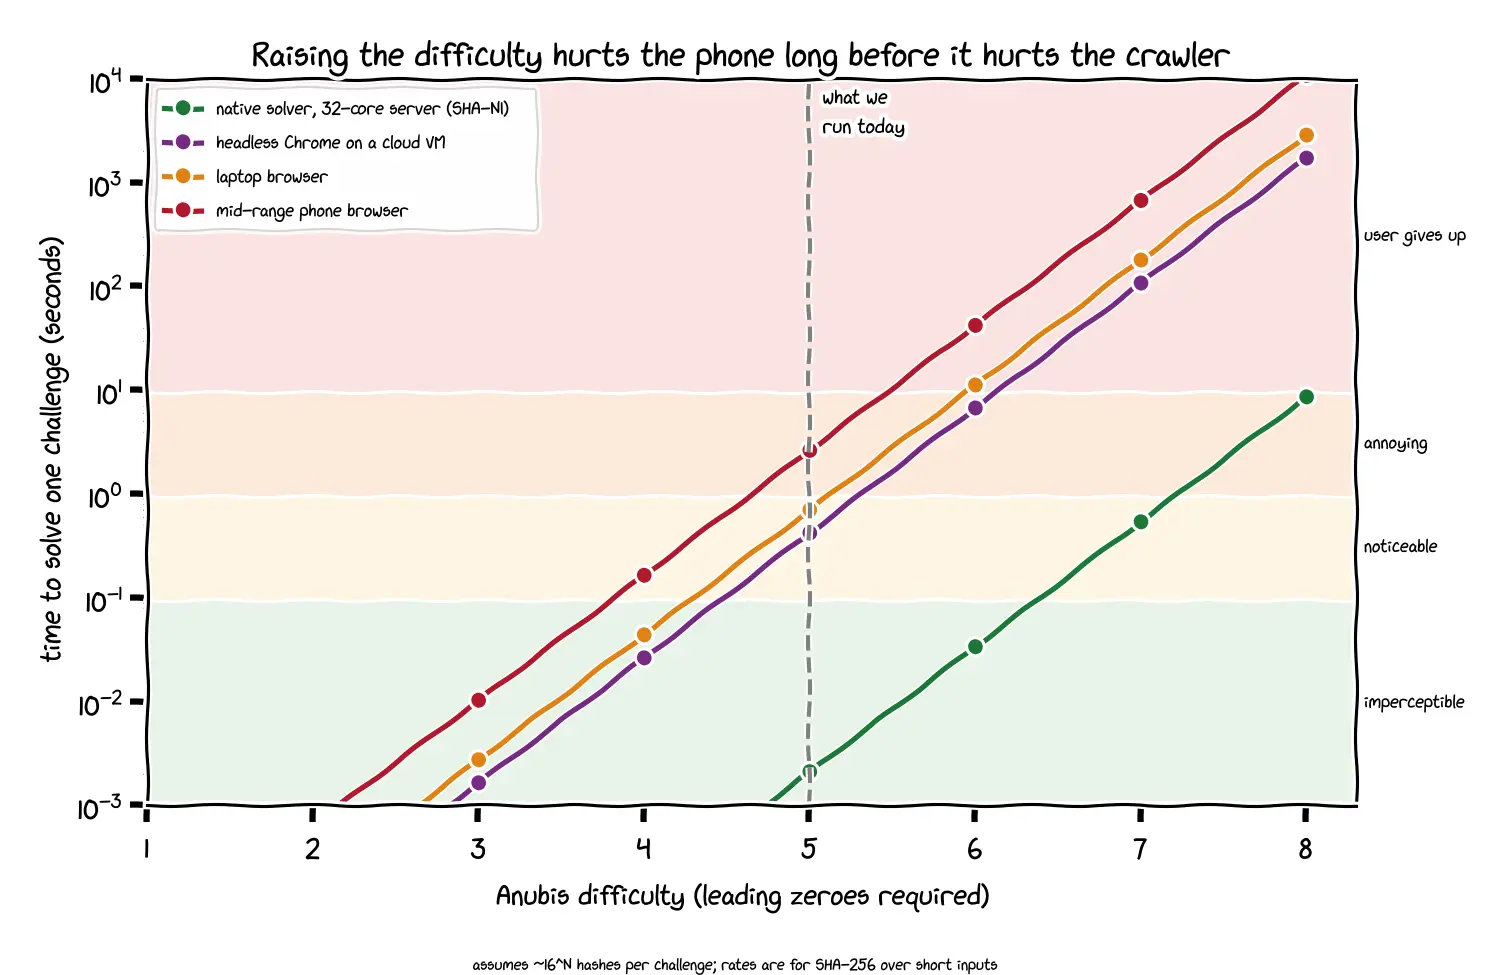
Reachy 团队约一年前部署了 Anubis 挑战:要求访客计算一个字符串——结合自己的 IP 和服务端提供的秘密——生成一个 sha256 哈希,前导零达到指定难度才能进门。初期极有效,爬虫直接放弃,平静了好几个月。然后爬虫回来了,能解难度 4。提到难度 5 后,手机用户要几秒才能算出来,"手机会明显发热"。又平静了几个月。现在爬虫已经能解难度 5。
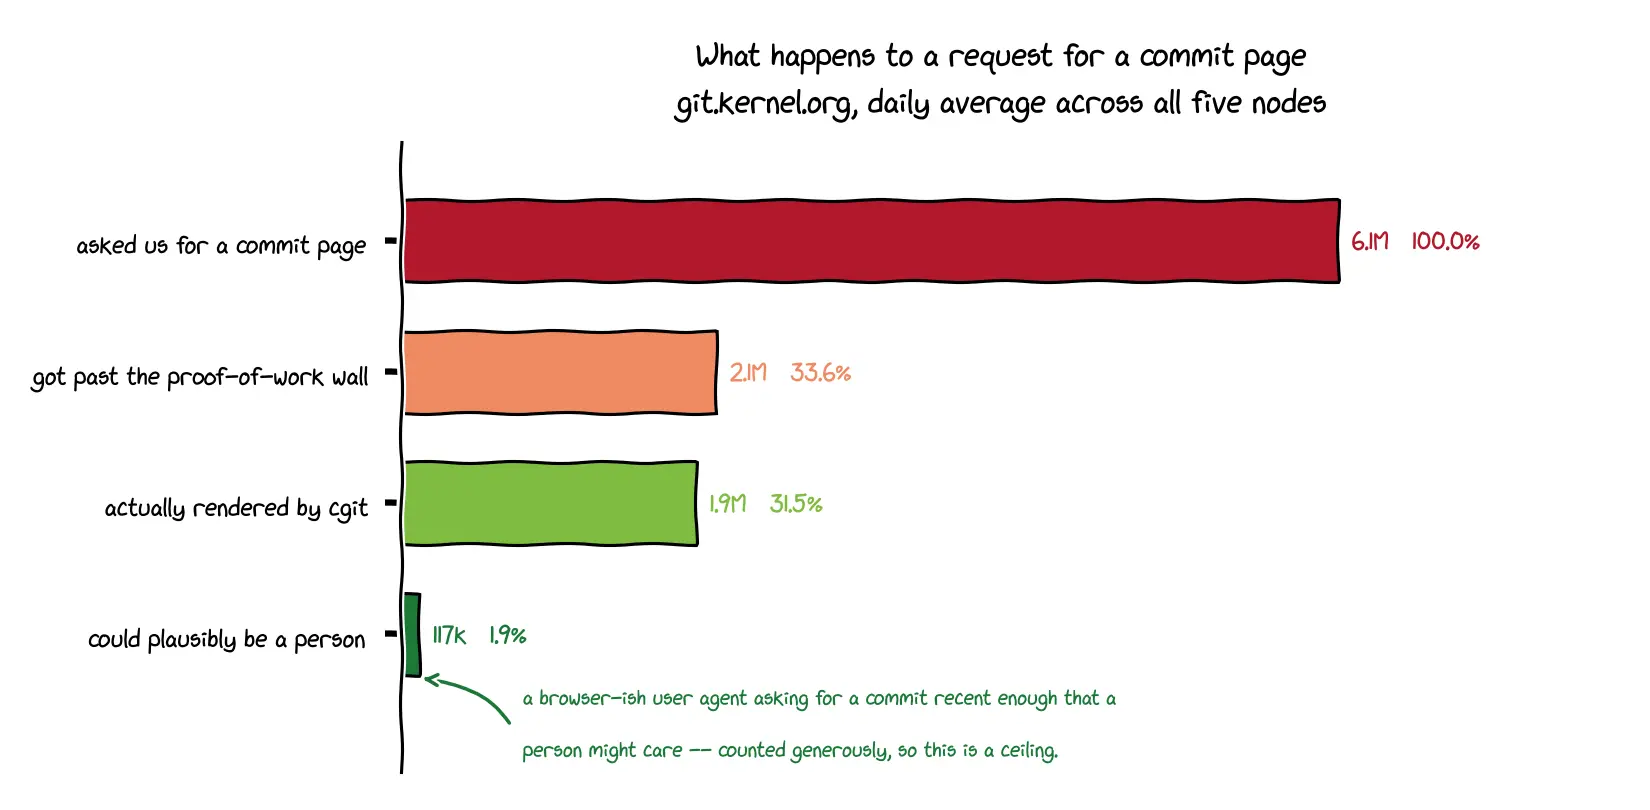
当前每天 600 万请求的构成是:66% 被 Anubis 挑战立刻挡回,33% 解开了数学题进了主站,而 Ryabitsev 估计真正的人类请求只有 2%。
讽刺的是,系统并没被爬虫压垮。真正让 git.kernel.org 宕机的,是那些设计糟糕的 CI 系统——"比如从 20 个不同节点对 stable.git 做 shallow clone 这种蠢事"。
Ryabitsev 在文末没有给出乐观的结论。结局不明朗——要么 AI 泡沫破裂,训练实体减少;要么爬虫学会更聪明地抓数据。团队正在关闭部分功能来减少可爬取的 URL 数量,匿名访问可能会失去一些便利。"相信我,我们和你们一样恨这个,但现在这是必须的。"
最坏的是没有简单的解法。新的 AI 公司还在不断冒出来,应用开发者还在找变现的方式,"他们会继续把你家的电器变成攻击载体"。
即便如此,他还是留了一句承诺:所有数据仍然会提供给任何索取的人,只是可能需要多一道验证。
文末用加拿大式的幽默收尾:"抱歉。(加拿大人的必备台词。)"
参考来源:
• Creepy crawlies — Konstantin Ryabitsev @ kernel.org
• Creepy Crawlies — Hacker News 讨论
原文链接 |
|



 发表于 2026-9-4 11:00:16